收藏!卷大模型的人沉默了!北京1亿政策扶持,赚钱机会转向Agent
你有没有发现一个现象?
2026年上半年,还在卷大模型训练的人,突然安静了。
取而代之的是另一群人——他们不训模型,不刷榜,不拼参数量,却在拿真金白银的订单。
这群人做的只有一件事: Agent应用开发。
而就在7月21日,北京正式印发《关于加快智能体引领发展的若干措施》—— 国内首个省级智能体全链条专项政策 ,关键技术攻关项目择优给予 最高1亿元 支持。
信号已经够明显了。
但问题来了: 政策在喊"智能体",行业在炒"Agent",你到底该怎么转?
今天这篇文章,我把近期所有热点和政策串起来,给你一条清晰的转型路径。不灌鸡汤,只讲实操。
一、先看懂趋势:为什么是Agent,不是大模型?
我们先把时间线拉一下:
2023年 ,所有人都在聊"百模大战"——谁家参数更大、跑分更高。
2024年 ,风向变了,大家开始聊"大模型应用"——RAG、知识库、智能客服。
2025年 ,"人工智能+“行动意见发布,政策层面把AI从"技术议题"升级为"国家战略”。
2026年7月 ,北京直接把 智能体(Agent)单拎出来做专项政策——注意,不是"大模型政策",不是"AI政策",而是智能体政策 。
这背后的逻辑其实特别朴素:
大模型是"大脑",但大脑不会自己干活。你需要一个"身体"——能感知、能决策、能执行、能协作。这个身体就是Agent。
北京的政策原文说得很直白:推动人工智能从模型层向 自主决策、多智能体协作 的"下一代能力"跃升。
翻译成人话: 会聊天的AI已经不够了,能干活的AI才是未来。
二、行业正在发生什么?8月的5个关键信号
光看政策不够,我们看看行业实际在干什么。2026年7-8月,整个Agent赛道发生了几件大事,每一件都在重新定义"Agent开发"的玩法:
信号1:Agent基础设施全面云化
Anthropic推出Managed Agents,跑出了"Brain/Hands/Session"解耦模板;Google把Gemini Managed Agents升级为后台异步Worker;OpenAI推出ChatGPT Agent + Responses API。
什么意思? Agent不再是Demo里的玩具,而是云上持续运行的服务。
以前你写一个Agent,要自己管状态、管记忆、管工具调用、管错误重试。现在?大厂把基础设施都铺好了,你只需要定义"这个Agent要干什么"。
信号2:长任务Agent突破24小时
8月,Meta发布Muse Code——后台Agent可以连续运行 24小时 ,完成1000+次工具调用。阿里Qwen3.8-Max自主编程 16天 。
这意味着什么?Agent的能力边界已经从"帮你写一段代码"扩展到"帮你完成一个项目"。
长程任务的稳定性,正在成为Agent开发的核心竞争力。
信号3:Harness范式崛起,Graph范式追上
7月份,翁荔(Lilian Weng)发布长文后,“Harness Engineering”(驾驭层工程)跻身Agent一线议题。
什么是Harness?简单说:大模型是马,Harness是缰绳和马鞍。你不需要更聪明的马,你需要更好的控制系统。
8月初,Peter Steinberger提出"Graph Engineering"——把AI组件组织成 可执行状态机图 。
行业的演进路线已经清晰了:
Prompt → Context → Harness → Loop → Graph
五层正交组合,每一层都是你可以发力的技术点。
信号4:Agent生态标准化
Amazon、Cursor、Microsoft、OpenAI、Vercel联合推出 Agent Plugins打包标准 ——用plugin.json统一Agent Skills与MCP servers的分发格式。
终结了什么?终结了"每个平台重写一遍扩展"的局面。
对开发者来说,这意味着你写的Agent插件可以跨平台复用——一次开发,多平台分发。
信号5:成本治理成为新命题
VentureBeat连续报道了一个扎心的事实:有工程师单日AI账单达600美元,有客服自动化项目直接烧穿预算。
Replit、Kilo Code、Symbotic现在都改为跟踪"每任务成本"而非原始花费。
结论很直接: Agent时代的技术选型正在从"跑分导向"转向"单位任务成本导向"。
你要选的不再是最强的模型,而是 性价比最高的模型+最合理的任务拆分 。
三、政策红利:北京给的真金白银
说完行业趋势,我们看看政策给的钱。毕竟,光有趋势不够,还得有钱支持你转型。
1. 智能体专项政策(市级)
-
关键技术攻关、共性平台、示范应用——择优最高 1亿元
-
探索发放 Token券、智能体服务券
-
支持OPC(一人公司)创业新模式
-
鼓励TaaS(Token即服务)、AaaS(智能体即服务)、RaaS(结果即服务)等新商业模式
2. 词元驱动智能经济政策(亦庄经开区)
-
目标2030年产业规模突破 4000亿元
-
每年发放 1亿元数据券
-
按词元消耗费用的50%给予企业最高 500万元 支持
-
OPC单个企业最高 100万元 累计补贴
-
租赁算力费用30%补贴,最高 2000万元
3. AI赋能科学研究方案
-
自主实验室体系建设
-
六大标杆场景:高能物理、材料科学、医疗健康、生命科学、量子科技、生物育种
-
"基础模型+专业模型"分层协同
如果你正在做Agent开发,或者准备转型,这些政策红利不是"看看就好"——它们是实打实的资金、算力和数据支持。
四、转型路径:从大模型开发者到Agent工程师
好,趋势看懂了,政策也清楚了。接下来是最实际的问题: 怎么转?
我给你拆成4个阶段:
第一阶段:认知重构(1-2周)
你需要丢掉三个旧认知:
旧认知1:模型能力=产品能力。 错。模型只是Agent的一个组件。上下文工程、工具调用、记忆管理、错误恢复——这些才是产品能力的决定因素。
旧认知2:Prompt Engineering就够了。 不够。Prompt只是五层架构的第一层。你需要理解Context Engineering(上下文工程)、Harness Engineering(驾驭层工程)、Agent Loop(智能体循环)和Graph Engineering(图工程)。
旧认知3:选模型看跑分。 过时了。Agent时代看的是"单位任务成本"和"长程任务稳定性"。
第二阶段:技术栈升级(2-4周)
从"调API写Prompt"升级到"构建Agent系统":
- 学会用Agent框架 :LangGraph(图编排)、Anthropic Managed Agents(托管服务)、OpenAI Responses API
- 掌握MCP协议 :Model Context Protocol正在成为Agent连接工具和数据的标准协议
- 理解状态管理 :短期记忆、长期记忆、任务持久化——这是长程任务稳定性的关键
- 学会成本治理 :任务级成本追踪、模型路由(简单任务用小模型,复杂任务用大模型)、Token缓存复用
第三阶段:场景落地(1-2个月)
不要追求"通用智能体",去找一个 足够窄、足够痛 的场景:
-
企业内部 :报表生成自动化、客服工单分类与路由、文档审核流水线
-
个人服务 :自媒体内容研究助手、投资信息聚合Agent、学习路径规划
-
行业垂直 :医疗病历结构化、法律文书检索与生成、科研文献综述
记住北京政策里的话:鼓励打造 数据驱动、自主决策的行业解决方案 ,在科学、医疗、制造等领域形成标杆性示范场景。
标杆场景=政策补贴+市场认可。
第四阶段:商业模式验证(持续)
Agent时代有三种新商业模式值得认真考虑:
-
TaaS(Token即服务) :你提供Token算力+模型能力,按使用量收费
-
AaaS(智能体即服务) :你提供成品Agent,按调用次数收费
-
RaaS(结果即服务) :你只对最终结果负责,按结果收费——这是最值钱的模式
RaaS为什么最值钱?因为客户不关心你用了什么模型、调了多少次API,他只关心"活干完了没有"。
能卖结果的Agent,才是真正成熟的Agent。
五、给不同人群的建议
如果你是后端工程师
你的优势是系统工程能力——状态管理、并发控制、错误处理、API设计。这些在Agent开发中全都需要,而且权重更高了。你需要补的是:理解大模型的能力边界和行为模式。
如果你是前端工程师
Agent的交互层正在爆发——从对话框到工作流编排器,从命令行到可视化Agent设计器。你的UI/UX能力在Agent时代有巨大价值。你需要补的是:理解Agent的执行流程,才能设计出好的可视化编排界面。
如果你是产品经理
好消息:Agent时代,产品思维比技术能力更稀缺。因为技术门槛在降低(大厂铺基础设施),但"什么场景该用Agent、什么场景不该用、怎么设计人机协作流程"——这些问题只有产品经理能回答。
关注三个关键词: 窄场景、强闭环、可审批。
如果你是独立开发者/自由职业者
北京政策明确支持OPC(一人公司)模式——AI赋能的新型创业形态。一个人+几个Agent=一家公司。
你不需要团队,你需要的是:
-
一个足够窄的场景
-
一个能稳定运行的Agent
-
一个愿意为结果买单的客户
亦庄经开区给OPC单个企业最高100万补贴。这不是画饼,这是真金白银。
六、最后说几句掏心窝的话
我知道很多人看到"Agent"这个词,第一反应是:又来了一个概念,跟去年的元宇宙、前年的Web3有什么区别?
区别在于: Agent不是一个概念,它是一个能力跃迁。
大模型让AI能"理解",Agent让AI能"行动"。
从"理解"到"行动",中间隔着的不是一行代码,而是一整套工程体系——上下文工程、工具调用、状态管理、多智能体协作、安全治理、成本控制。
这套体系正在被搭建,而且速度比你想象的快。
北京用1个亿的专项资金告诉你方向,行业用24小时不间断运行的Agent告诉你时机。
剩下的,就看你了。
七、转型资料,整理好了
文章写到这里,该说的都说透了。但光看文章确实学不会开发——方向有了,还差资料、路线和案例。
所以我把这段时间攒的《Agent应用开发转型资料包》整理了一下,分享给大家:
1. Agent开发完整学习路线图(高清版) 从Prompt → Context → Harness → Loop → Graph,五层架构对应哪些技术、看哪些文档、练哪些项目,一条路线走完,不绕路。
2. 北京智能体政策全文+重点解读 市级的《若干措施》和亦庄的《词元经济措施》原文,补贴金额、申请条件、责任部门都标好了,想拿补贴的可以直接对照自查。
3. 50个Agent落地案例库 企业内部、个人服务、行业垂直,三类场景50个真实案例。每个案例拆了场景痛点、Agent架构、技术选型、成本结构,参考价值比较高。
4. 主流Agent框架对比表(2026年8月版) LangGraph、Anthropic Managed Agents、OpenAI Responses API、开源自建……适用范围、上手难度、成本模型、适合人群,一张表看清。
5. 高频面试题+参考答案 最近在面Agent岗的朋友可以参考,能省不少准备时间。
资料会持续更新——政策出新、框架发布,我都会同步进包里。领过的朋友不用重复扣。
最后再啰嗦一句:
转型最怕的不是技术难,而是 信息差 。
政策在变、框架在变、商业模式在变——你不需要比所有人快,只需要比同行快一步。
资料包就是帮你补上这一步的。
2026 技术圈彻底洗牌!传统岗位不断缩减,吃透 AI 大模型,手握高薪入场券
步入 2026,技术行业两极分化已经成为常态。
后端 CRUD、前端页面开发、软件测试、常规运维这类传统岗位持续缩招,降薪、人员优化早已变成家常便饭。不少深耕多年的技术兄弟陷入深深的职业焦虑,害怕年龄上涨之后,被低成本 AI 代码工具替代。
反观 AI 大模型赛道,各大企业正在疯狂招人。落地型大模型开发岗位薪资一路暴涨,头部大厂常年放出 70‑100W 年薪招揽实干人才。如今企业不再死板卡死年纪门槛,比起只会背诵理论的人,更渴求可以落地项目、解决企业业务难题的实战人才。
2026 小白和在岗程序员该怎样系统学好 AI 大模型?
很多兄弟有心踏入大模型赛道,却总是卡在自学难题上面。
一部分人四处搜集零散网课、碎片化文档,知识结构杂乱无章,越学越迷茫;还有不少人冲动入手高价培训课程,花费不菲,学到的仅有演示 Demo,缺少企业级落地项目,白白浪费宝贵时间不停踩坑。
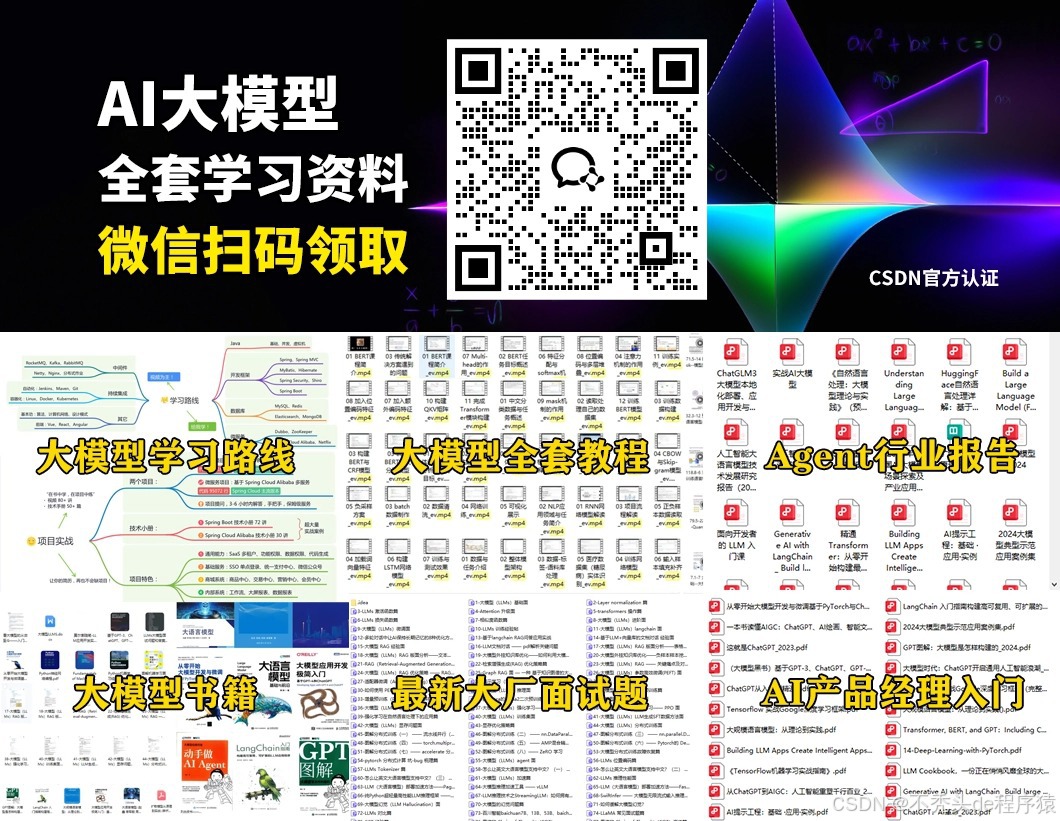
我这边整理好了一套适配 2026 行业招聘标准、免费且体系完整的 AI 大模型全套学习资源包。覆盖零基础入门、工程实战、底层原理深耕、大厂面试备考整条链路,所有资料已经规整完毕,不需要你到处搜集拼凑,拿到之后直接开启学习,小白循序渐进,老程序员专攻高阶内容实现薪资跃迁。
👇👇扫码免费领取全部内容👇👇
一、大模型专属系统化学习路线
整套学习路线参考今年企业用人标准和新手学习习惯定制,规划好从零基础到独立搭建企业级大模型项目的每一步,可以帮你规避八成以上无用功,躲开新手常见误区,高效完成技能升级。
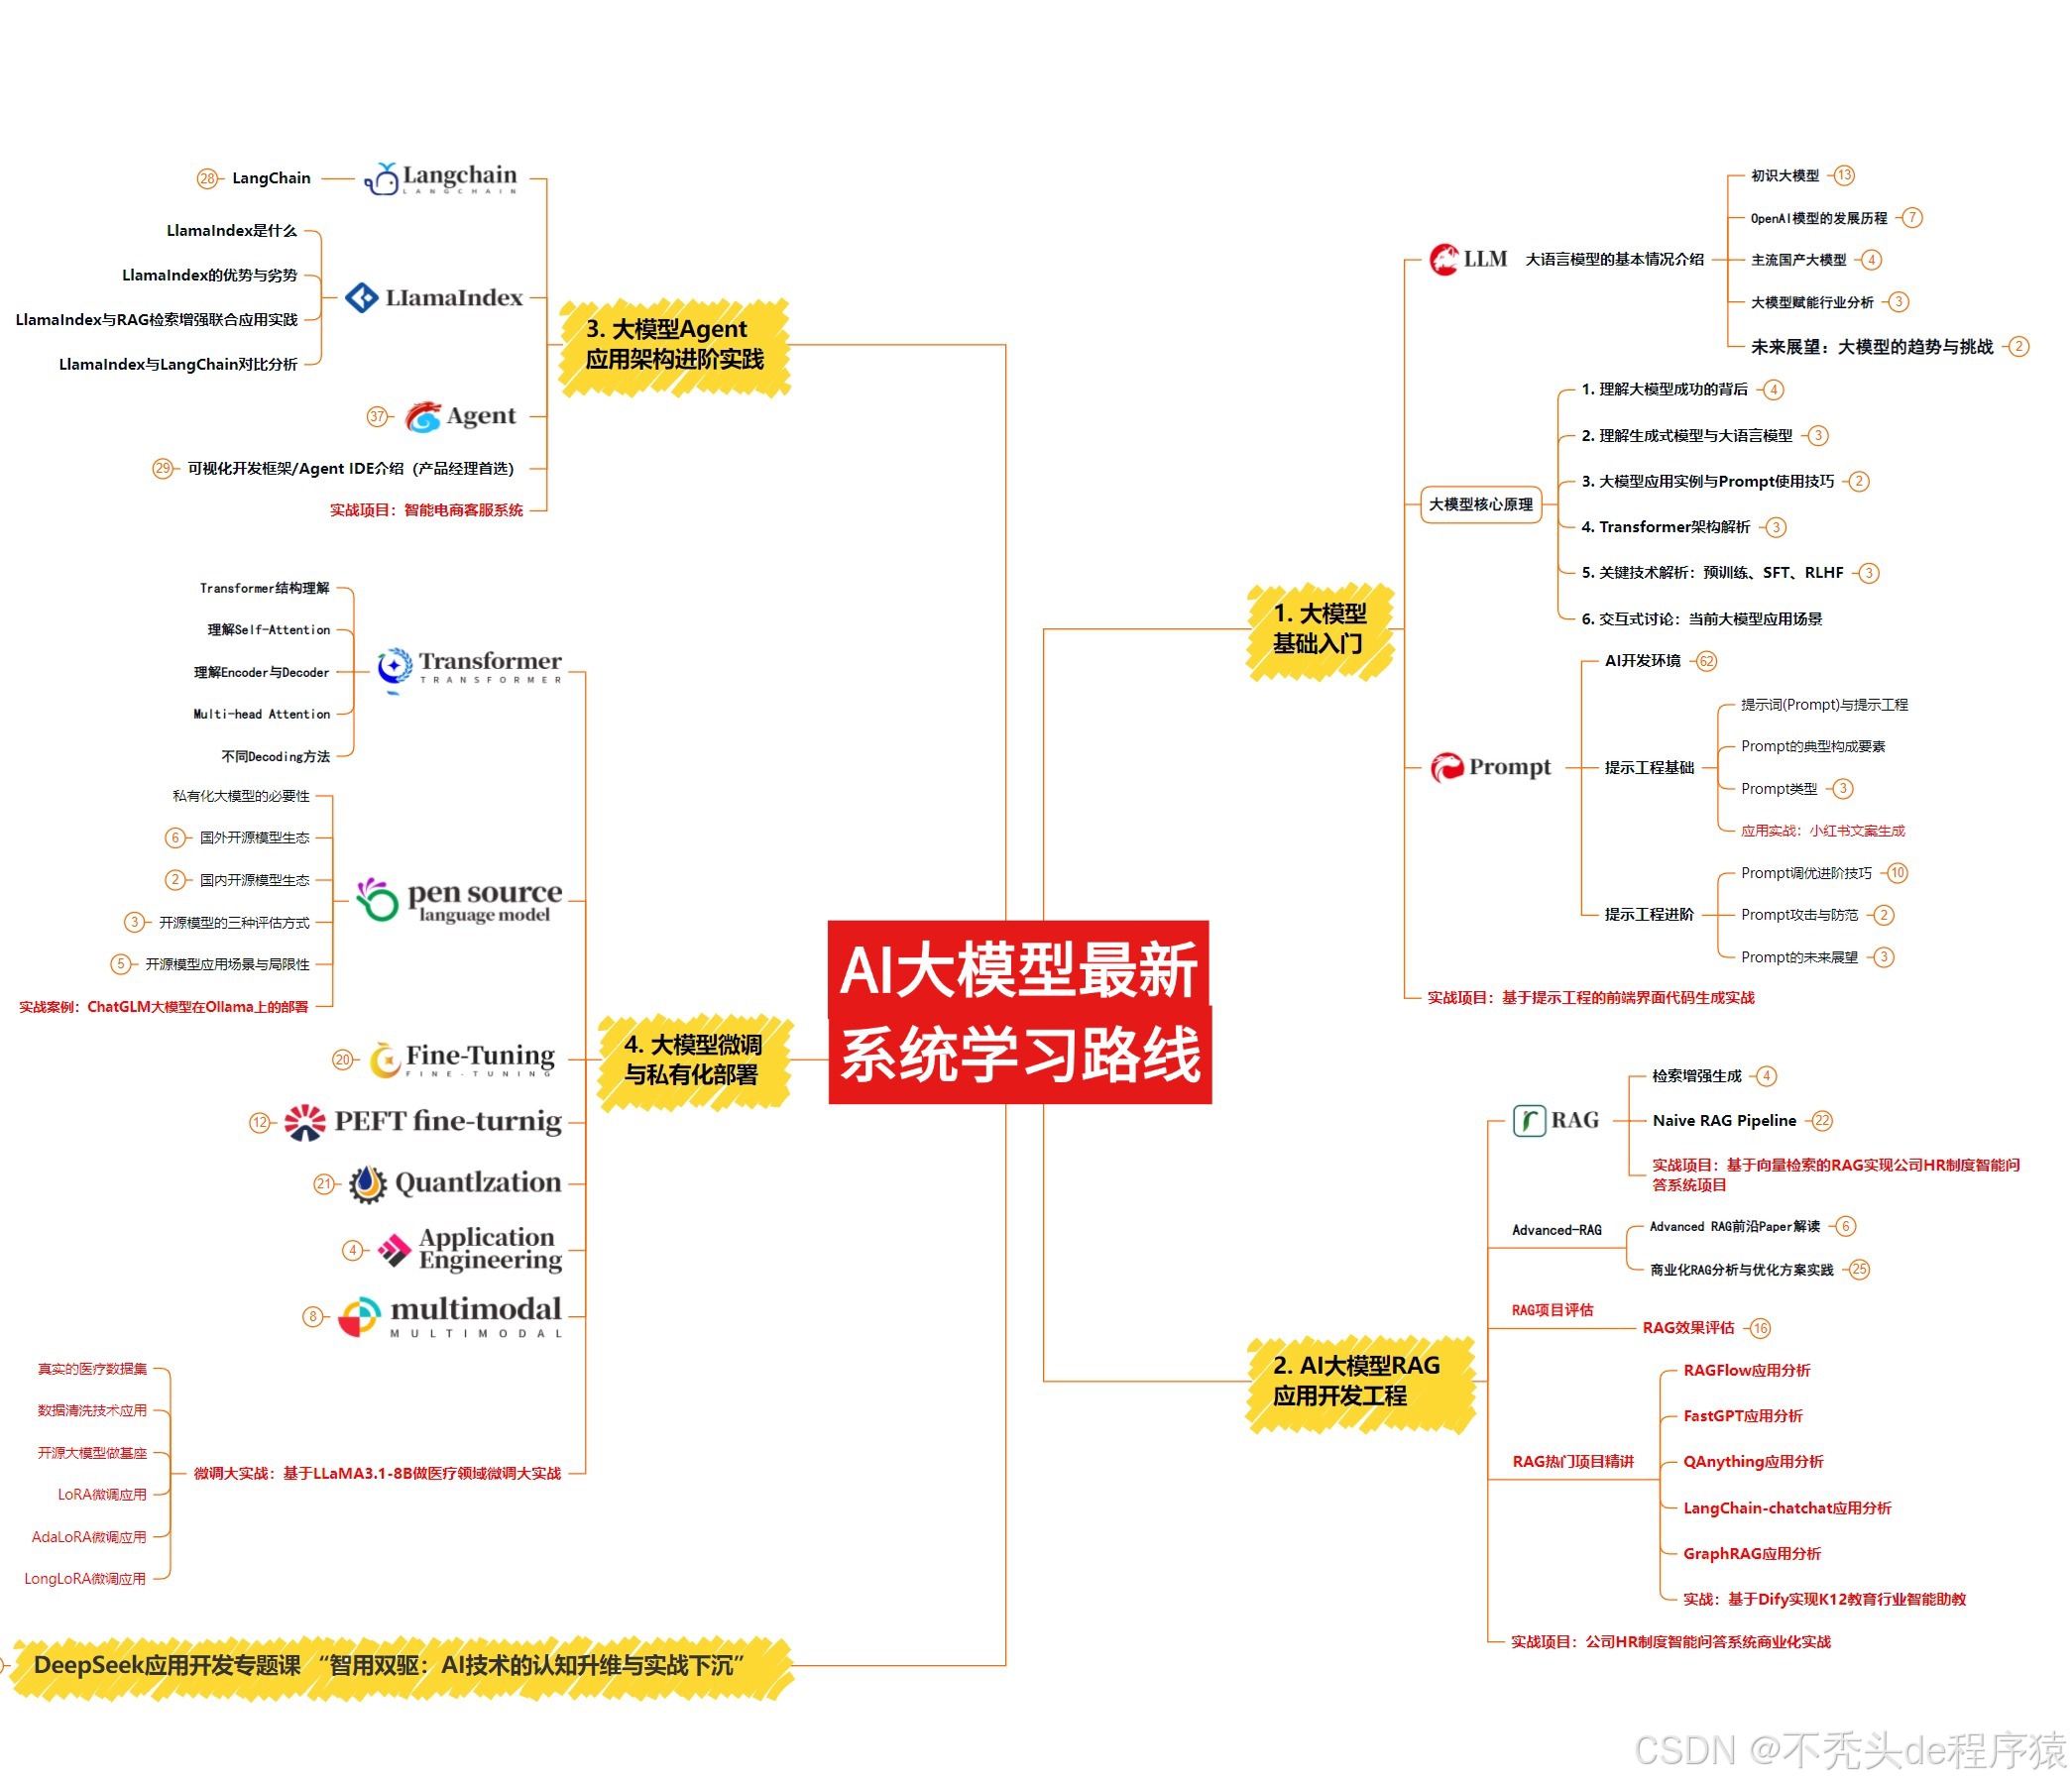
二、零基础到高阶实战全套视频教程
包含大模型基础认知、高阶提示词、RAG 检索增强、开源模型微调、向量数据库、私有化部署、AI‑Agent 智能体开发全套教学视频,跟着实操练习,降低自学门槛。
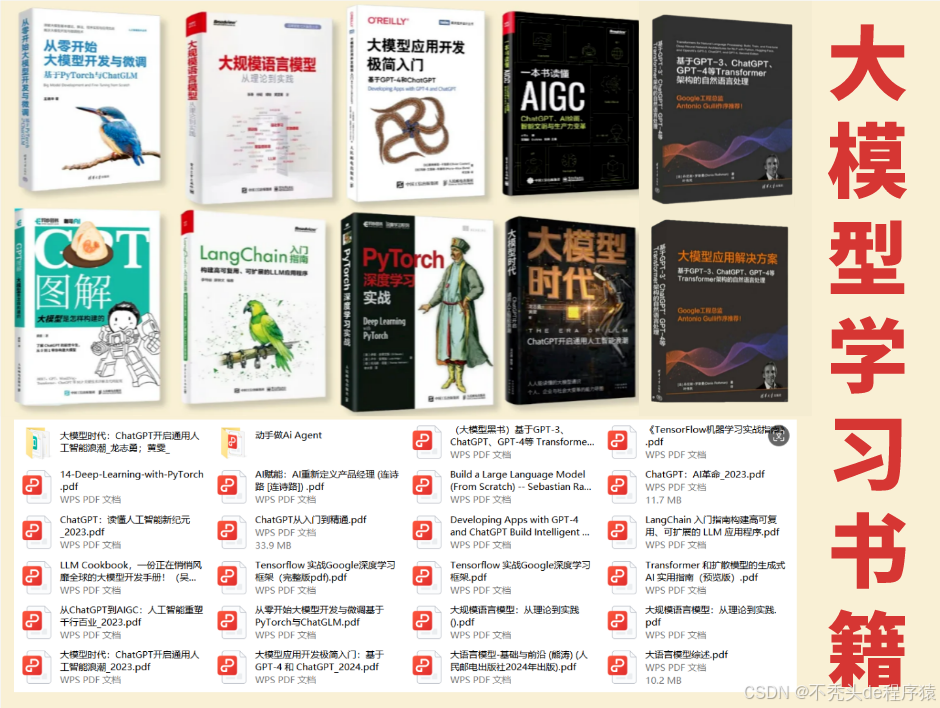
三、技术电子书与干货文档
收纳 2026 前沿技术要点,Transformer 底层架构、提示词工程、RAG 工程落地、轻量化微调、MCP 通信协议、vLLM 推理加速、大模型安全管控等全部具备详细讲解。
四、最新 AI 行业调研报告
汇集头部互联网厂商、第三方调研机构行业资料,国产主流大模型横向测评、企业 AI 落地白皮书、大模型岗位薪资调研报告,方便你紧跟行业风向,找准就业、副业方向。
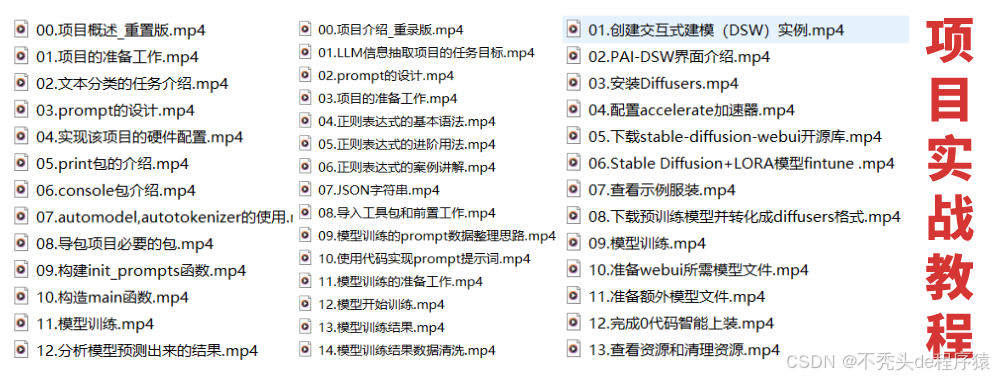
五、可直接运行实战项目以及配套源码
内置 DeepSeek 私有知识库搭建、多模态微调、RAG 企业文档问答、本地开源大模型部署、多智能体协同等当下热门实战案例,附带完整可运行源码。做完之后既可以锻炼实操能力,项目案例还能够直接写到简历用来求职。
六、2026 大厂大模型岗位面试真题
现如今大模型岗位面试早已不再只考察枯燥的理论原理,面试官重点考察项目落地、线上故障排查、业务改造经验。很多技术功底过硬的兄弟缺少针对性刷题准备,面试屡屡碰壁,这份真题补齐你的备考短板。
适配学习人群
零基础转行新人、Java 后端开发者、前端工程师、测试工程师、运维、数据分析从业者、打算拓展 AI 副业的职场人。
九十天可落地分阶段学习计划
第一阶段(10 天・基础应用入门)
学完之后你的大模型认知已经超越绝大多数普通使用者。旁人只会和 AI 闲聊对话,你可以定制专业提示词,编写简易代码,打通业务系统和大模型。
- 熟悉各大主流大模型的商业化落地场景
- 搞懂大模型产生智能的底层逻辑
- 掌握借助 AI 提升工作效率的核心思路
- 吃透 AI 应用业务架构、技术架构
- 学习提示词结构、思维链、思维树实操
- 了解提示词攻击风险以及对应的防御手段
第二阶段(30 天・RAG 高阶实战阶段)
主攻私有知识库搭建,开发专属对话智能体,吃透主流大模型开发框架,适配 Python、JavaScript 两类开发者。
- 弄懂什么时候需要搭建检索增强知识库
- 动手搭建 PDF 企业文档问答系统
- 吃透 Embedding 向量嵌入基础知识点
- 向量数据库实操、混合检索优化方案
- 本地部署向量模型、性能调优
第三阶段(30 天・模型训练微调阶段)
到此阶段学习完毕,你已经具备应聘大模型岗位的硬性实力,可以独立微调垂直行业专属大模型,上手开源多模态大模型。
- 分清预训练、全量微调、轻量化微调之间区别
- 动手搭建简易神经网络小实验
- 训练数据集清洗、搭建规范
- Transformer 架构逐层拆解
- 低成本本地微调实操方案
第四阶段(20 天・项目部署和商业闭环)
熟悉各类大模型吞吐量、推理成本参数,可以搞定云端、本地私有化部署,找寻适合自身的副业方向。
- 大模型本地运行硬件配置挑选
- 多款国产商用大模型优劣势对比
- vLLM 推理加速部署教程
- 公有云平台私有部署开源大模型实操案例
- 完整开源 LLM 项目搭建流程
- AI 项目内容安全、互联网算法备案相关知识
👇👇扫码免费领取全部内容👇👇!
不少兄弟疑惑,这套学习资源含金量如何?
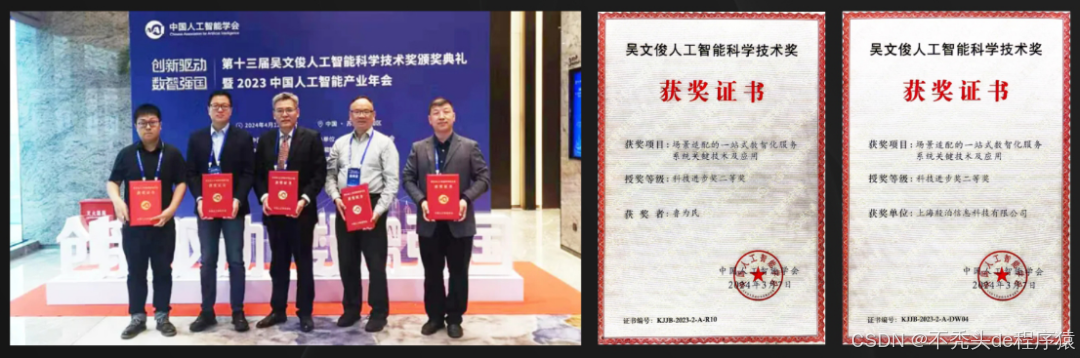
整套学习资料由我和鲁为民博士一同整理编撰。博士本科就读清华大学,于加州理工学院取得博士学位,现如今担任殷泊信息科技 CEO;他打造的 MoPaaS 云平台拿下国际权威机构认证,服务国家电网、航天科工等上千家大型企业;累计发表五十余篇 IEEE 专业论文,手握三十余项国内外 AI 相关专利,斩获吴文俊人工智能相关奖项。
整套教程全部立足于企业真实落地需求,摒弃花架子演示 Demo。不管你是零基础新手,还是拥有多年编程阅历的技术从业者,整套材料都能够助力你吃透大模型技术、实现薪资上涨、顺利转型 AI 高薪赛道。
完整版 AI 大模型全套学习资料已经上传 CSDN,有需要的兄弟可以微信扫描 CSDN 官方二维码免费领取,全套资源永久免费获取。
这里是“一人公司”的成长家园。我们提供从产品曝光、技术变现到法律财税的全栈内容,并连接云服务、办公空间等稀缺资源,助你专注创造,无忧运营。
更多推荐
 6
 0
- 0


 已为社区贡献28条内容

所有评论(0)