Few-shot vs Zero-shot Learning:为什么 GRPO 治不好 Agent 的“话痨”?从数据合成视角看 Few-shot 的不可替代性
一、 业务背景:DeepResearch 下的 Planning 任务
近期,我们公司正在自研一套 DeepResearch(深度投研/深度研究) Agent 系统。在该系统的 Agentic Workflow 中,Planning(计划生成) 是最核心的前置调度节点。
一个合格的 Planner 节点,其核心任务是接收用户的宽泛宏观/微观投研问题(如:“分析人民币贬值对出口企业的影响”),并将其拆解为一系列高度精炼、逻辑严密、可供后续检索/执行工具直接调用的动作指令。它不需要对问题本身进行解答,只需要给出“怎么去研究”的步骤。
在调研阶段我们发现,现有的 Gemini 原生 DeepResearch 功能在 Planning 任务上表现极佳。其生成的研究计划具有极高的信息密度:总体字数严格控制在 300-600 字之间,每个独立步骤的指令长度在 40-68 字左右。
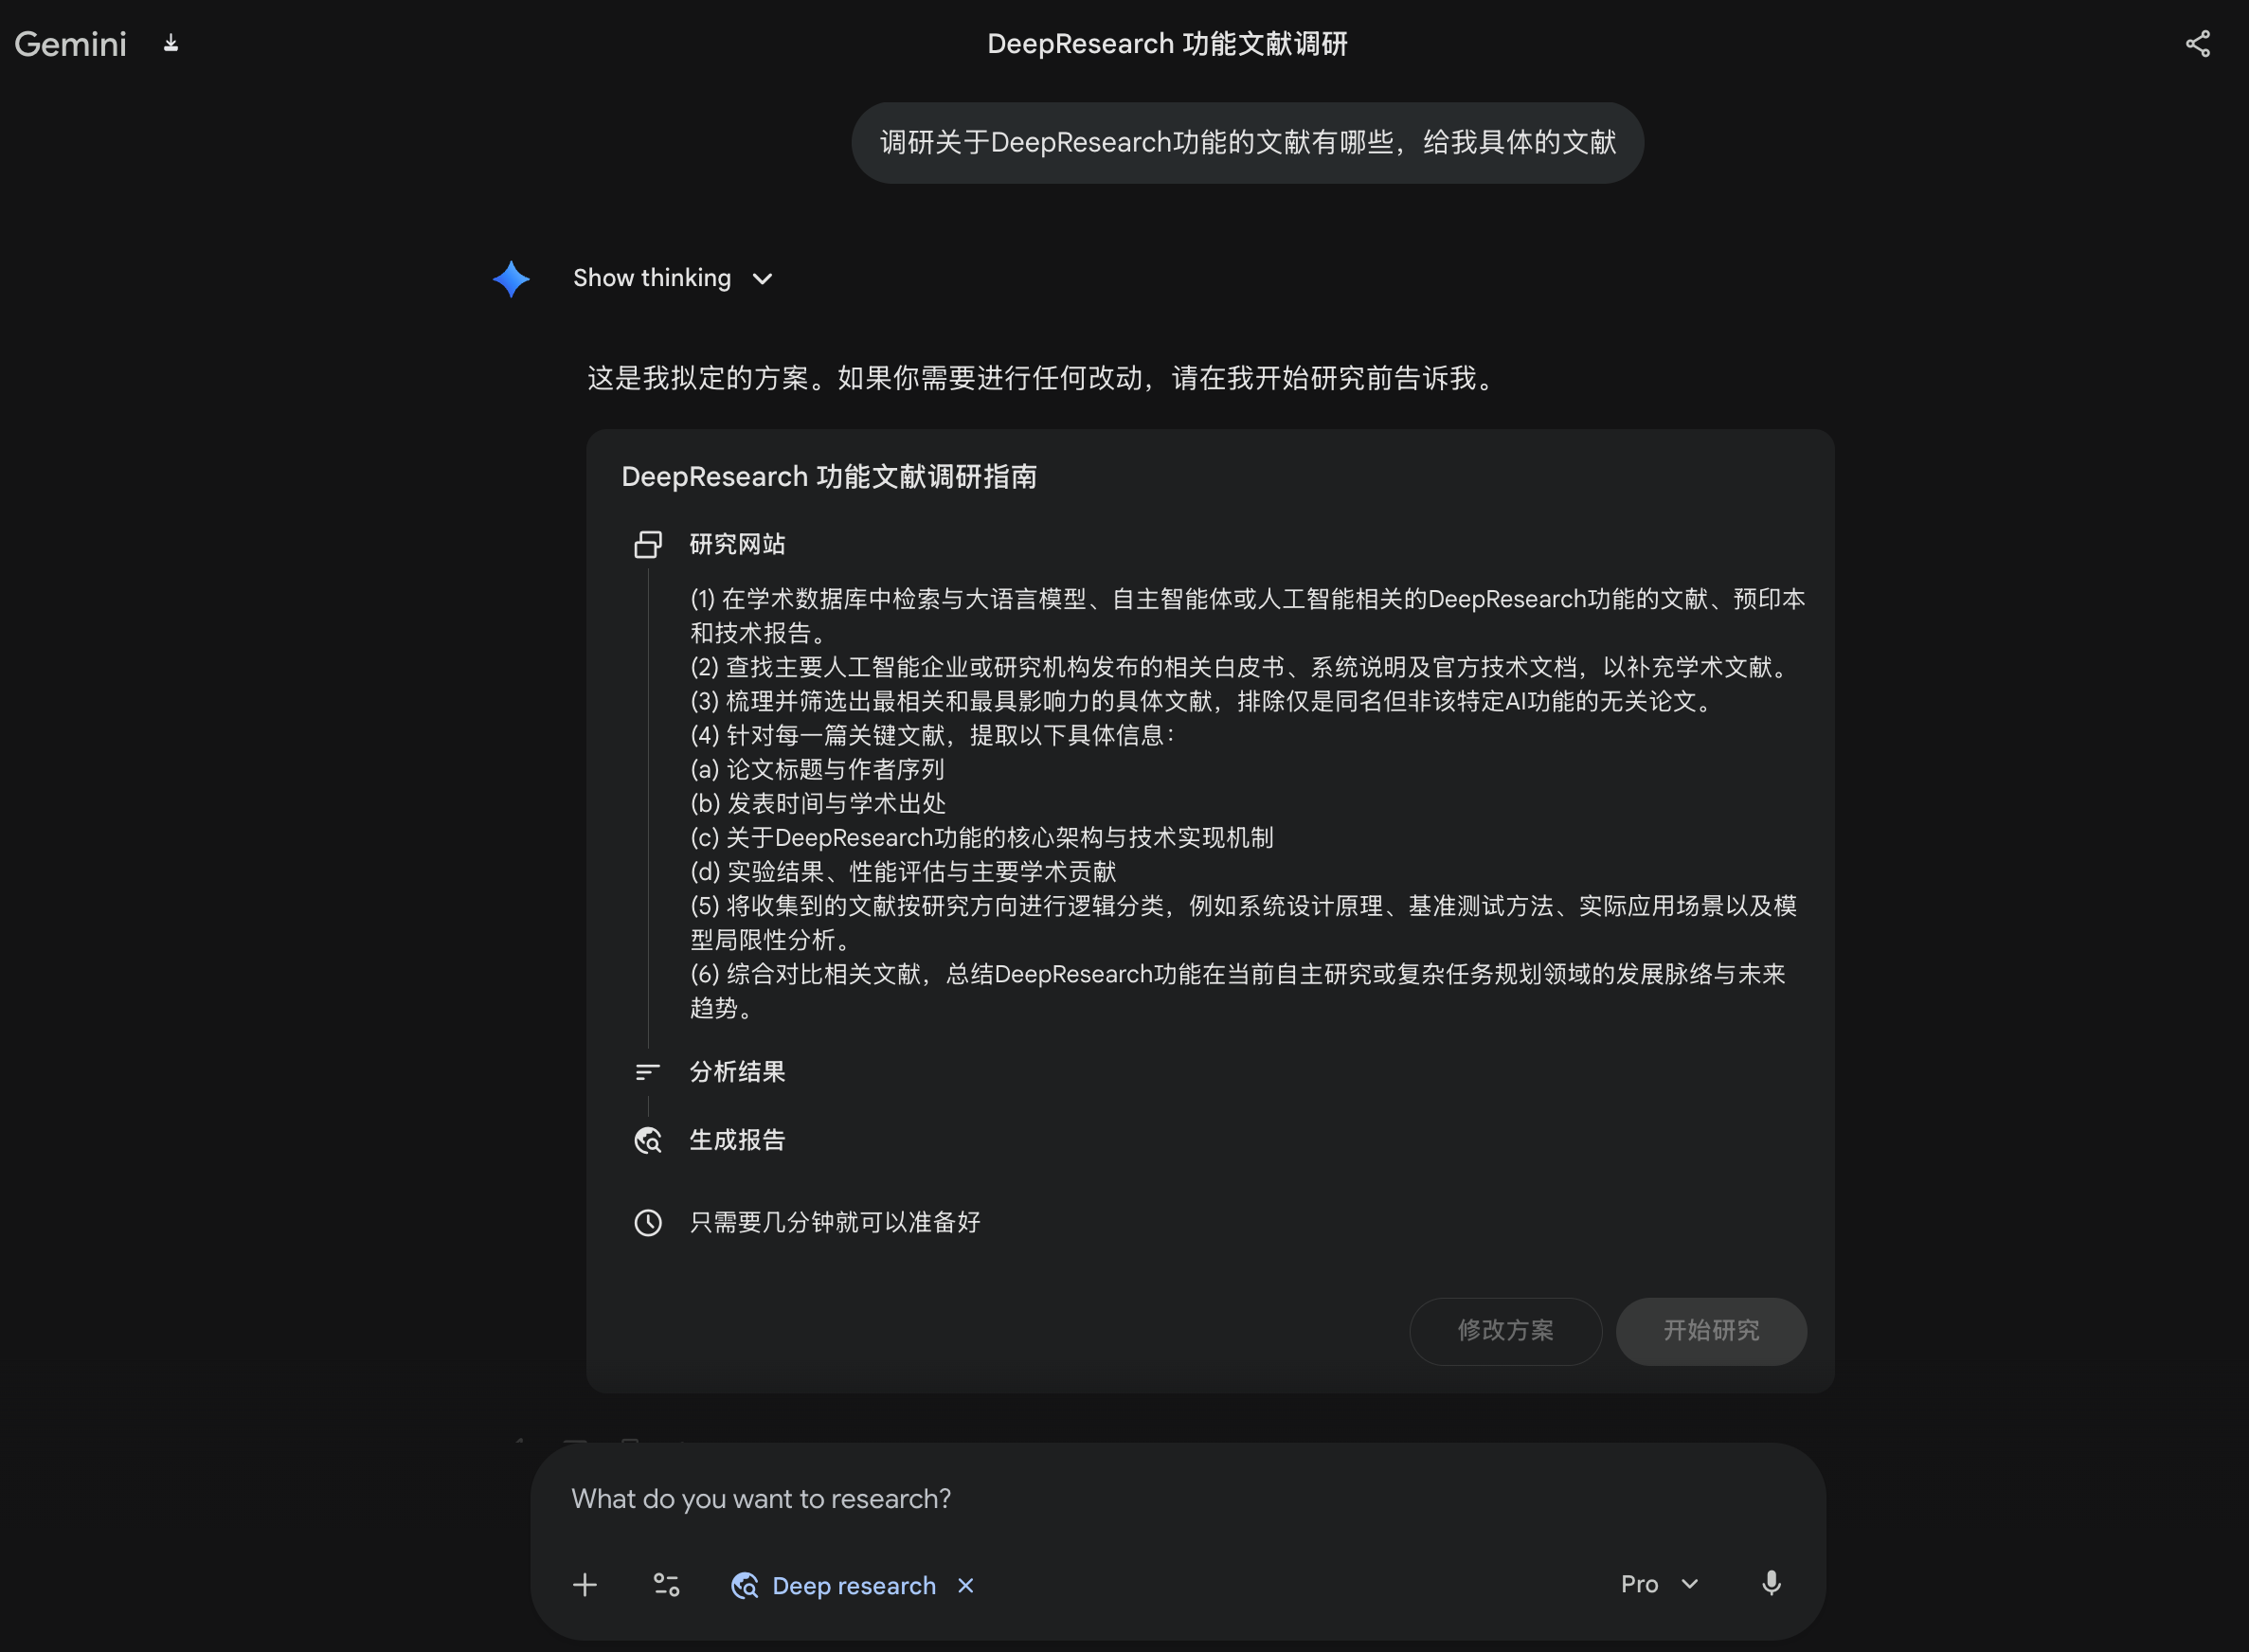
图:Gemini自带的DeepResearch功能表现极好
为了将这种优秀的 Planning 能力蒸馏并复刻到我们自研的模型中,我们需要构建一批高质量的 SFT(监督微调)数据集。按照常规的蒸馏思路,我们决定采用 Gemini 3 Pro 的 API 作为 Teacher Model,合成大约两百条金融投研计划数据。
二、 初始方案的失效:API 基础模型的“冗长偏好”
在 V1 版本的数据合成方案中,我们采取了“人工总结规律 + 复杂 Prompt 约束”的 Zero-shot(零样本) 生成策略:
- 我们人工调用 Gemini,对 10 个高质量的投研问题生成了参考 Plan。
- 总结这些优秀 Plan 的原生逻辑特点(例如:必须以动作动词开头、不能包含多余的因果解释、字数受限)。
- 将这些规律编写为详尽的 System Prompt,采用 Zero-shot(零样本) 纯指令驱动的方式,调用 Teacher Model 批量生成剩余数据。
在工程实践后,我们遭遇了严重的数据质量衰退: 合成出来的 200 条数据发生了严重的长度膨胀与语义稀释。对比指标如下:
- 真实参考基准:Plan 总长 300-600 字,步均 40-68 字。
- Zero-shot 生成数据:Plan 均长突增至 789 字,步均长达 115 字。
Teacher Model 完全无视了我们在 Prompt 中千叮咛万嘱咐的“尽量精简”指令。它在每一个步骤里不仅写了“要做什么”,还自作主张地解释了“为什么要这么做”、“这对于金融市场的意义是什么”,充满了因果分析的废话。
技术归因:商业大模型的基础 API 经历了深度的 RLHF(基于人类反馈的强化学习),其底层逻辑极度偏好“Helpfulness(详尽、有帮助)”。在缺乏上下文示例(In-Context)强制约束的情况下,纯自然语言的Zero-shot Prompt 无法对抗模型底层的冗长偏好。模型不可避免地发生“角色退化”,将原本“供机器读取的精炼指令”退化成了“带有大量背景铺垫和因果分析的拟人化报告”。
三、 试图走捷径的代价:强化学习阶段的对齐灾难
在发现 SFT 训练数据偏长后,我们并未立即重构数据合成管线,而是试图在模型的强化学习(RL / GRPO)阶段通过调整 Reward Function 来进行被动纠偏。
在 SFT 训练导致模型同样沦为“话痨”后(因为基础训练数据就偏长),我们在 RL 阶段引入了严格的 Length Penalty(长度惩罚项):当模型生成的计划总长度或单步长度超出阈值时,直接给予负向 Reward。
然而,这次尝试彻底宣告失败,模型出现了典型的“模式崩溃”:
- Reward 饱和与梯度消失:模型凭借长篇大论轻易命中规则奖励,组内方差降至 0,Policy 模型的梯度更新彻底停滞。
- SFT 阶段决定了模型的“行为基础分布”。既然模型在 SFT 阶段摄入了均长近 800 字的“话痨”数据,其内部的 Token 转移概率就已经固化为高延展性状态*。
- 在这种分布上强加 RL 长度惩罚,模型并没有学会“提炼核心信息”,而是为了规避惩罚,在中途强行输出
<eos>(结束符),导致生成的计划逻辑断裂、步骤缺失,根本无法在真实业务中执行。
Token 层面的解释是这样的: 在语言模型的生成逻辑中,每一步输出下一个 Token,是基于前面的上下文计算出来的概率分布。在经历了“话痨”数据的 SFT 后,模型在遇到诸如“因此”、“但是”等逻辑词时,生成大量后续解析 Token 的概率被训练得极高,而生成结束符
<eos>(End of Sequence)的概率极低。 当我们在 RL 阶段强加“超出长度扣分”的规则时,模型为了最快拿到 Reward 分数,采取了最粗暴的捷径:强行改变分布,在步骤没写完时,直接拉高<eos>的输出概率。这就好比一辆还在高速行驶(持续输出内容)的汽车突然拉起手刹(强行<eos>),导致最终输出的 JSON 或文本结构直接断头,无法被下游程序解析。
更为tech层面的解释:
RLHF 训练动态、KL散度约束、以及 Policy Gradient (策略梯度) 底层逻辑
1、SFT 阶段决定了基础策略(Reference Policy)的概率空间:
在自回归生成中,模型每一步都在拟合条件概率
。因为我们在 SFT 阶段喂入了均长近 800 字的冗长数据,模型学到的概率分布是:在生成完一个动作指令后,紧接着生成“因果解释”、“背景知识”相关 Token 的 Logit 值极高。换句话说,“精炼概括”这种句式分布,在当前的基础模型权重中,其初始发生概率几乎为零。
2、KL 散度约束限制了“剧烈的语法重构”:
在标准的强化学习对齐(如 PPO)目标函数中,为了防止模型发散,通常会引入对抗基础模型的 KL 散度惩罚项:
。 当我们在 Reward 侧引入苛刻的长度惩罚时,模型遇到了两难:
- 路线 A (我们期望的): 学习全新的精炼句式。但这要求彻底推翻
中固有的高概率词元转移路径,这会导致巨大的 KL 惩罚(
),在梯度更新上阻力极大。
- 路线 B (模型实际选择的): 维持前置句式不变,仅仅在逼近长度限制时,强行拉高结束符
<eos>的生成概率。3. Policy Gradient 的捷径:Reward Hacking(奖励作弊)
神经网络是极其“功利”的优化器。相比于在整个生成轨迹上艰难地调整数以千计 Token 的概率基准(路线A),“在特定位置剧烈提升单个
<eos>Token 的 Logit 值”(路线B)是一条阻力最小的下降路径。这直接导致了 Policy 模型走上了 Reward Hacking 的歧途——它并没有理解“精简”的语义,而是发现只要及时吐出<eos>提前阻断生成,就能规避长度扣分。
这次失败的尝试验证了 Post-training 领域的一个铁律:“RLHF 的作用是唤醒和对齐能力,而不是创造能力(RL aligns well, but does not create)”。如果 SFT 阶段的监督信号没有勾勒出“精炼指令”的概率子空间,RL 阶段无论设计多复杂的 Reward 惩罚,Policy 梯度都无法向一个不存在的真值空间收敛,最终只能退化为粗暴截断的 Mode Collapse。这也是为什么我们最终必须回归 Data-Centric,利用 Few-shot 在 SFT 源头重新锚定分布的原因。
四、 破局点:回归 Data-Centric,重构 Few-shot 数据管线
Data-Centric:以数据为中心的 AI,由吴恩达系统性提出,它的核心思想是区别于传统的 Model-Centric(以模型为中心)
工程实践证明:试图通过下游的 RL 算法去修补上游 SFT 数据分布的缺陷,注定是徒劳的。
我们必须回到源头解决数据合成的质量问题。既然文字描述的 Rule-based Prompt 压不住 Teacher Model 的冗长分布,我们就必须利用 LLM 的 In-Context Learning(上下文学习) 能力,用真实的概率分布去锚定输出边界。
由此,我们将数据合成的管线从 Zero-shot 彻底重构为 Dynamic Few-shot(动态少样本采样)。以下是我们对 Few-shot 原理的深入分析,以及它是如何在实操中锁死模型的长度与格式分布,最终产出符合 DeepResearch 业务要求的高质量数据的。
- ❌ Model-Centric(以模型为中心)的思维定势: 当遇到模型表现不佳时,算法工程师的第一反应是:改网络架构、加深层数、调超参数(Learning Rate)、或者像我们之前踩坑时那样——在损失函数(Loss)或强化学习(RL)阶段绞尽脑汁地增加各种复杂的惩罚项。这个流派认为:数据是静态的死的,模型算法才是活的、需要不断折腾的。
- ✅ Data-Centric(以数据为中心)的破局思维: 保持模型架构和基础算法相对稳定,将 80% 的精力投入到“持续提升数据质量、数据多样性、数据格式的纯净度”上。这个流派认为:数据本身就是算法的代码(Data is the new codebase)。如果模型输出乱了,那一定是喂进去的数据分布出了问题。
补充:Few-shot Learning - 解决样本较少的问题
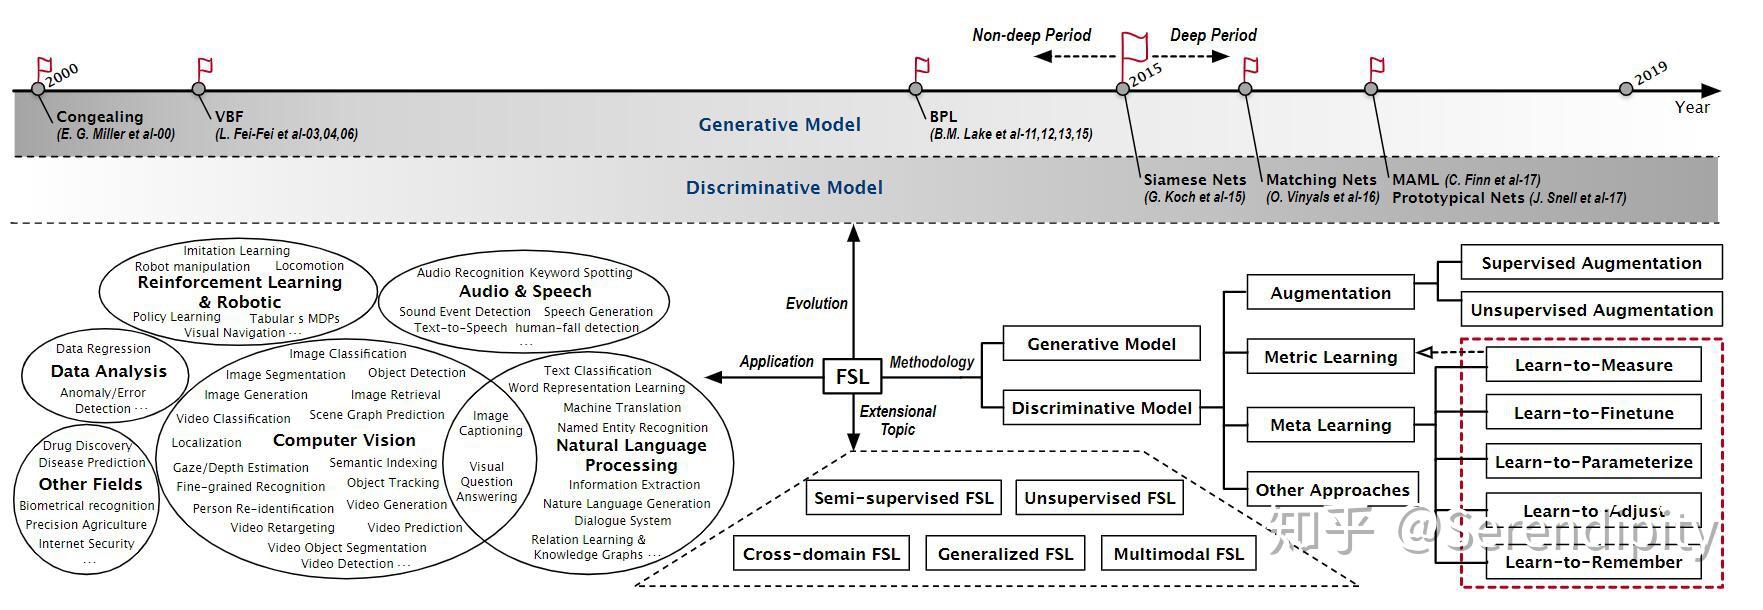
图:FSL(Few-shot Learning)发展历程
一、什么是 Few-shot?
Few-shot 是一种 In-Context Learning 技术。核心思想非常简单:
不修改模型权重,而是在 Prompt 中给模型几个"示例",让模型通过类比推理来完成新任务。
类比人类学习:老师不讲理论,直接给你看 3 道例题和标准答案,然后让你做第 4 道题。你通过观察例题的"模式"来推断答案格式。
二、Few-shot 的三种形态
Zero-shot(零样本):只给指令,不给示例
  "请生成一份金融研究计划。"
  → 模型自由发挥,格式和风格不可控

One-shot(单样本):给 1 个示例
  "示例:Query=XXX, Plan=XXX。请模仿生成。"
  → 有基本格式参考,但风格单一

Few-shot(少样本):给 3-5 个示例  ← 我们用的
  "示例1:... 示例2:... 示例3:... 示例4:... 请模仿生成。"
  → 模型从多个示例中提取共性模式,输出质量最高
三、Few-shot 的工作原理(为什么有效?)
大语言模型在预训练阶段读了海量文本,学会了一种能力:模式识别与延续。
当你在 Prompt 中放入多个 (Query, Plan) 对时,模型会:
Step 1: 识别模式
  模型发现:每个示例都是 "Query → (1)动词开头...(2)动词开头...(3)..." 的格式

Step 2: 提取共性规则(隐式的)
  - 格式规则:用 (1)(2)(3) 编号,子项用 (a)(b)(c)
  - 长度规则:每步大约 50-80 字,总共 5-8 步
  - 风格规则:以"搜索""分析""对比""综合"等动词开头
  - 内容规则:涉及宏观→行业→公司的递进逻辑

Step 3: 应用规则到新 Query
  收到新的 Query 后,模型按照提取的规则生成新的 Plan
关键点:模型并没有"学习"(权重没变),而是在推理时"模仿"。这就是为什么叫 In-Context Learning——学习发生在上下文中,而非参数中。
四、在本项目中的两处 Few-shot 应用
应用 1:数据生成阶段(Teacher Model 生成训练数据)
目的:让 Teacher Model(qwen3-30b)生成符合参考标准的研究计划
位置:synthetic_plan_generator.py 的 System Prompt

System Prompt 结构:
┌─────────────────────────────────────────┐
│ 角色定义:你是金融投研分析师...           │
│ 输出格式:用(1)(2)(3)编号...             │
│ ⚠️ 长度约束:350-550字,步均50-85字...   │
│                                         │
│ 示例1: Query=美联储降息... Plan=(1)...(5)│  ← Few-shot
│ 示例2: Query=社融M2...    Plan=(1)...(6)│  ← Few-shot
│ 示例3: Query=比亚迪财报... Plan=(1)...(8)│  ← Few-shot
│ 示例4: Query=固态电池...   Plan=(1)...(8)│  ← Few-shot
└─────────────────────────────────────────┘
User: "分析人民币贬值对出口企业的影响"       ← 新 Query
Assistant: (1) 搜索... (2) 分析... (6) 综合... ← 模仿示例生成
为什么从 12 条中随机抽 4 条?
- 全放 12 条:Prompt 太长(~6000字),浪费 token,且可能超出模型注意力窗口的有效范围
- 只放 1-2 条:风格单一,模型容易过度模仿某一条的特定表述
- 随机抽 4 条:每次生成看到不同的示例组合,增加输出多样性,减少同质化
应用 2:SFT 训练阶段(训练数据本身就是 Few-shot 的"固化")
Few-shot 的局限:
  - 每次推理都要在 Prompt 中放示例 → 浪费 token
  - 示例数量受 Prompt 长度限制 → 最多放 4-5 个
  - 模型只是"模仿",没有真正内化规则

SFT 的作用:
  - 把 Few-shot 的"模仿"变成"内化"
  - 用 200 条 (Query, Plan) 对修改模型权重
  - 训练后的模型不需要示例就能生成正确格式 → Zero-shot 就够了
本质关系:
Few-shot(推理时给示例)→ 生成训练数据 → SFT(修改权重)→ 模型内化规则
                                                        ↓
                                              推理时不再需要示例(Zero-shot)
五、Few-shot 的数学直觉
从概率角度理解,LLM 本质是在做条件概率:
P(Plan | Query)                          ← Zero-shot,不确定性大
P(Plan | Query, 示例1, 示例2, 示例3, 示例4)  ← Few-shot,条件更充分

示例越多、越相关,条件概率分布越集中(熵越低),
模型输出越确定、越符合你想要的格式。
六、V1 vs V2 的 Few-shot 差异(为什么 V1 数据膨胀)
V1 的问题:
  - 只用了 4 条手写示例(不是来自 xlsx 参考数据)
  - 示例本身就偏长(~150字/步)
  - Prompt 中没有明确的长度约束
  → Teacher Model 学到了"写长一点"的模式 → 生成数据平均 789 字

V2 的修复:
  - 用 xlsx 中全部 12 条真实参考数据(平均 461 字,步均 65 字)
  - 每次随机抽 4 条,确保多样性
  - Prompt 中加入严格的长度约束(350-550字)
  → Teacher Model 学到了"精简"的模式 → 预期生成数据 ~460 字
七、总结
| 概念 | 说明 |
|---|---|
| Few-shot 是什么 | 在 Prompt 中给几个示例,让模型通过类比推理完成任务 |
| 为什么有效 | LLM 预训练学会了"模式识别与延续"能力 |
| 局限性 | 只是推理时的"模仿",没有修改权重;受 Prompt 长度限制 |
| 与 SFT 的关系 | Few-shot 生成数据 → SFT 将模式固化到权重中 → 不再需要示例 |
| 本项目中的作用 | 控制 Teacher Model 生成数据的格式、长度和风格 |
| 关键经验 | 示例质量决定生成质量;示例来源必须是"榜样标准" |

这里是“一人公司”的成长家园。我们提供从产品曝光、技术变现到法律财税的全栈内容,并连接云服务、办公空间等稀缺资源,助你专注创造,无忧运营。
更多推荐


 25
 0
- 0


 已为社区贡献1条内容

所有评论(0)