Agent 时代的第一工程能力:Harness Engineering
2026年2月,一个名词在AI工程圈子里突然火了起来——Harness Engineering。
Mitchell Hashimoto在博客里提了这个说法,OpenAI紧接着发了百万行代码的实验报告,Martin Fowler跟进了深度解读,LangChain公开了具体的中间件设计和量化数据。两周内,这个概念完成了从个人博客术语到行业级工程概念的跃迁。
但如果你以为这只是一波新炒作,那就错了。仔细看这波讨论的背后,是过去一年里多组独立实验积累的量化证据——它们指向同一个结论:在Agent系统中,系统设计对最终结果的影响,已经超过了模型本身的能力。
这才是真正值得关注的。
三组改变信仰的数据
先看三组实验数据。
2026年2月,LangChain做了个实验:他们的编码Agent在Terminal Bench 2.0排行榜上排第30名。然后他们没有换模型,没有加数据——只是优化了Agent外围的约束系统、反馈回路和验证机制。结果排名从第30跳到了第5。
同期,安全研究者Can Bölük做了个更极端的实验:同一个模型(Grok Code Fast 1),仅改变编辑工具的格式(从patch换成他设计的hashline),表现从6.7%飙到68.3%——10倍差距,模型一行没动。
Vercel的经验方向一致但策略相反:削减了80%的Agent工具,换来的是更少的步骤、更少的token消耗和更快的响应。
这三组数据指向同一个结论:在Agent系统中,模型不是瓶颈,模型之外的一切才是。
这个"模型之外的一切",现在有了一个名字——Harness Engineering。
从三次范式跃迁说起
理解Harness Engineering,需要把它放在一个更大的背景下。
过去几年,AI工程的范式经历了三次跃迁。
第一阶段:Prompt Engineering。你在优化指令本身的表述——怎么说话AI才能听懂。这是最基础的层面。
第二阶段:Context Engineering。你不只是优化指令,还优化AI做决策时能看到的所有信息——给AI看什么比怎么说更重要。
第三阶段:Harness Engineering。你开始设计整套物理基础设施——缰绳、马鞍、围栏和道路维护。确保马在正确的道路上跑,跑偏了有围栏挡回来,跑累了有反馈告诉你。
Phil Schmid(Hugging Face AI总监)给了另一个精准的类比:模型是CPU,Harness是操作系统,Agent是应用程序。无论CPU多强大,操作系统糟糕的话性能依然低下。
用一句话区分:Context Engineering问的是"给Agent看什么",Harness Engineering问的是"系统如何防止、测量和修复Agent的行为"。
OpenAI的百万行实验
2026年2月11日,OpenAI发表了"Harness engineering: leveraging Codex in an agent-first world"。这篇文章以一个极端实验为载体——3人团队从空仓库出发,5个月用Codex Agent写了约100万行产品代码,零人类手写。
这是迄今最详尽的Harness Engineering工程实践记录。
他们的核心做法是:
设计环境而非写代码。Agent遇到困难时追问"环境里缺什么"而不是让Agent更努力。
仓库即唯一真相来源。所有知识推入Git,AGENTS.md作索引,渐进式披露。
机械式架构约束。linter的报错信息本身就是修复指南——工具在纠正Agent的同时也在教Agent。
可观测性接入。让Agent能捕获DOM快照、查询日志和指标,把目标变成可测量的。
对抗熵增。自动化"垃圾回收Agent"持续扫描偏离黄金原则的代码。
他们一开始也踩了坑。尝试写一个"巨大的AGENTS.md"——失败了。上下文太拥挤,Agent要么忽略关键约束,要么开始优化错误的东西。文档迅速过时,变成一个无人维护的负担。
后来他们换了个思路:把AGENTS.md当作目录,而不是百科全书。一个100行左右的入口文件作为地图,指向更深层的知识来源。具体的知识放在结构化的docs/目录里,有专门的linter和CI job验证文档是否及时更新。
还有一个关键洞察:在Agentic工程中,很多传统工程规范反而成了障碍。他们的仓库运行着极简的merge gates,PR生命周期很短,测试flake通常通过重试解决而不是阻塞进度。在一个Agent产出远超人类注意力的系统里,修正很便宜,等待很昂贵。
控制论视角:同一个模式出现了三次
George Zhang(OpenClaw维护者)提供了一个非常有洞察力的视角:读完OpenAI的文章后,他意识到这个模式见过不止一次,而是三次。
第一次是18世纪80年代。瓦特发明了离心调速器。在这之前,工人得一直守在蒸汽机旁边调节阀门。有了调速器后,一套机械装置会自动感知转速、调节阀门。工人工作内容变了:从亲手拧阀门,变成设计调速器本身。
第二次是Kubernetes出现后。你只需要声明目标状态(运行三个副本、用这个镜像),控制器会持续监测实际状态,偏差了自动修正。工程师的工作从手动重启服务,变成编写系统需要对齐的spec。
第三次就是现在。OpenAI描述的工程师不再亲手写代码,而是设计运行环境、构建反馈回路、把架构约束转化成可执行的规则。OpenAI把这种工作方式叫做"harness engineering"。
每一次变化的背后是同一个模式。诺伯特·维纳在1948年给这个模式命名为"控制论"(cybernetics)。这个词来自希腊语,意思是"舵手"。本质含义是一样的:你不再需要亲手拧阀门,而是开始掌舵。
这个模式每次出现,背后都有同一个原因:有人造出了足够强大的传感器和执行器,能够在那个层面上把反馈回路闭合起来。
现在,LLM同时改变了两端:它能像人一样判断代码质量和进行改动,又能在端执行修复。这是第一次,反馈回路可能在真正关键的决策层面闭合。
五大核心组件
Harness Engineering不是一个单一的东西,它是五个组件的组合:
知识管理:Agent不了解项目。把团队知识变成Agent可发现的结构化文档。
约束系统:好的指令被忽略,坏模式被复制。用机械化规则替代口头约定,报错即教学。
反馈回路:Agent不知道自己做得对不对。让目标可测量,让Agent能自我验证。
熵管理:技术债务以Agent的速度积累。自动化"垃圾回收",持续对抗架构退化。
状态与记忆:跨会话、跨context window的连续性。结构化进度文件加版本化存储。
实战:LangChain的三个中间件
LangChain的Terminal Bench实验给出了具体的harness组件设计,可操作性很强。
PreCompletionChecklistMiddleware。在Agent准备退出任务时拦截它,注入一条提醒:必须对照任务规格做一次验证。这强制了一个"构建→验证"循环。
LoopDetectionMiddleware。通过tool call hooks追踪每个文件编辑次数。当对同一文件编辑超过N次时,注入上下文建议Agent重新考虑方案。他们观察到某些情况下,Agent会对同一个错误方案反复微调10多次。
LocalContextMiddleware。Agent启动时自动映射当前工作目录和周边目录,发现可用工具。减少Agent在环境导航上浪费的时间和token。
还有一个值得注意的策略——“推理三明治”:不是全程使用最高推理等级,而是xhigh→high→xhigh三段式。初始规划用xhigh高质量方案设计,实现阶段用high快速执行避免超时,最终验证再用xhigh严格检查。
他们的量化结果很有说服力:基线52.8%,全程xhigh推理53.9%(因超时反而效果不佳),全程high推理63.6%,完整Harness优化66.5%。
注意看:全程xhigh推理甚至不如全程high推理。Harness层面的优化比单纯提高推理等级的效果大得多。
映射到你的工具链
如果你在用Claude Code,好消息是你已经有了一套现成的harness工具箱:
- • CLAUDE.md:仓库知识聚合、架构约束声明(Context层)
- • Commands:可复现的常规任务执行(Harness层)
- • Hooks:自动化事件触发处理(Harness层)
- • Skills:最佳实践注入(Context层)
- • MCP Servers:外部工具/数据连接(Context或反馈循环)
- • Permissions:自动批准范围定义(Harness层)
关键区分是:CLAUDE.md和Skills属于Context层(优化单次推理的输入),而Commands、Hooks、Permissions属于Harness层(约束系统的长期行为)。
很多人把所有东西都塞进CLAUDE.md里试图解决问题,但如果你的问题在Harness层,再大的CLAUDE.md也不够。
成熟度阶梯
最后,给你一个采用模型。每一层解决一类问题,向上叠加:
L0 裸用:每次对话从零开始,Agent像每天换一个新人。
L1 指令层:把项目知识写下来。单次输出稳了,但跨任务还是乱。
L2 约束层:让机器替你执法。Agent反复犯同一类错。
L3 工作流层:把重复动作标准化。反复下达同一套指令序列。
L4 委托层:多Agent分工协作。单Agent上下文不够用了。
L5 治理层:权限、审计、沙箱。从个人工具变成团队基础设施。
大多数团队当前在L0-L1。L1解决"Agent不了解项目",L2解决"Agent了解但不遵守",L3解决"Agent遵守但需要人工编排"。把L2-L3做扎实就已经能显著改善Agent的可靠性。
写在最后
Harness Engineering指向的问题是真实的:当模型能力趋同后,你的竞争力取决于模型之外的一切——约束、反馈、知识管理、熵治理。
从工程师的角度看,这是一次角色进化。你的工作从"写代码"变成了"设计让Agent可靠地写代码的系统"。
OpenAI那句标语说得很直白:Humans steer. Agents execute.
你不再是执行者,你是基础设施的建设者。
学AI大模型的正确顺序,千万不要搞错了
🤔2026年AI风口已来!各行各业的AI渗透肉眼可见,超多公司要么转型做AI相关产品,要么高薪挖AI技术人才,机遇直接摆在眼前!
有往AI方向发展,或者本身有后端编程基础的朋友,直接冲AI大模型应用开发转岗超合适!
就算暂时不打算转岗,了解大模型、RAG、Prompt、Agent这些热门概念,能上手做简单项目,也绝对是求职加分王🔋
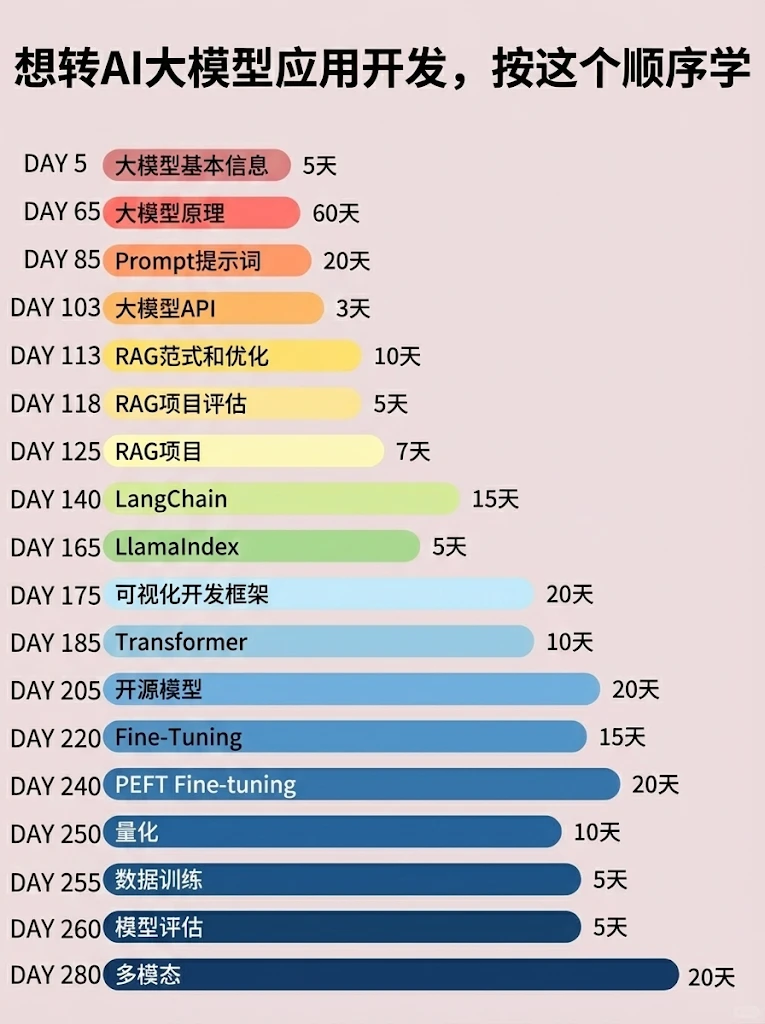
📝给大家整理了超全最新的AI大模型应用开发学习清单和资料,手把手帮你快速入门!👇👇
学习路线:
✅大模型基础认知—大模型核心原理、发展历程、主流模型(GPT、文心一言等)特点解析
✅核心技术模块—RAG检索增强生成、Prompt工程实战、Agent智能体开发逻辑
✅开发基础能力—Python进阶、API接口调用、大模型开发框架(LangChain等)实操
✅应用场景开发—智能问答系统、企业知识库、AIGC内容生成工具、行业定制化大模型应用
✅项目落地流程—需求拆解、技术选型、模型调优、测试上线、运维迭代
✅面试求职冲刺—岗位JD解析、简历AI项目包装、高频面试题汇总、模拟面经
以上6大模块,看似清晰好上手,实则每个部分都有扎实的核心内容需要吃透!
我把大模型的学习全流程已经整理📚好了!抓住AI时代风口,轻松解锁职业新可能,希望大家都能把握机遇,实现薪资/职业跃迁~
这份完整版的大模型 AI 学习资料已经上传CSDN,朋友们如果需要可以微信扫描下方CSDN官方认证二维码免费领取【保证100%免费】


这里是“一人公司”的成长家园。我们提供从产品曝光、技术变现到法律财税的全栈内容,并连接云服务、办公空间等稀缺资源,助你专注创造,无忧运营。
更多推荐



 5
 0
- 0


 已为社区贡献65条内容

所有评论(0)