Python基础
文章目录
环境配置和使用
环境搭建
Python 解释器详解
Python 是高级编程语言,无法直接被计算机执行,需通过解释器将代码转换为机器语言(01 二进制)。常见解释器类型:
- CPython:官方默认版本,C 语言开发,应用最广泛
- IPython:交互式解释器,增强了 CPython 的交互体验
- PyPy:JIT 编译型解释器,执行效率远超 CPython
- Jython/IronPython:分别运行在 Java/.NET 平台的解释器
环境安装(Anaconda)
(1)Anaconda/Miniconda/Conda 的区别
- Conda:底层包管理和环境管理工具
- Anaconda:“全家桶”,包含 Conda+Python+1500+数据科学库+图形化工具(体积约 500MB-1GB)
- Miniconda:迷你版,仅包含 Conda+Python+核心依赖(体积小,适合定制化环境)
(2)安装步骤
1 下载对应系统版本的 Anaconda(官网:https://www.anaconda.com/)开始安装
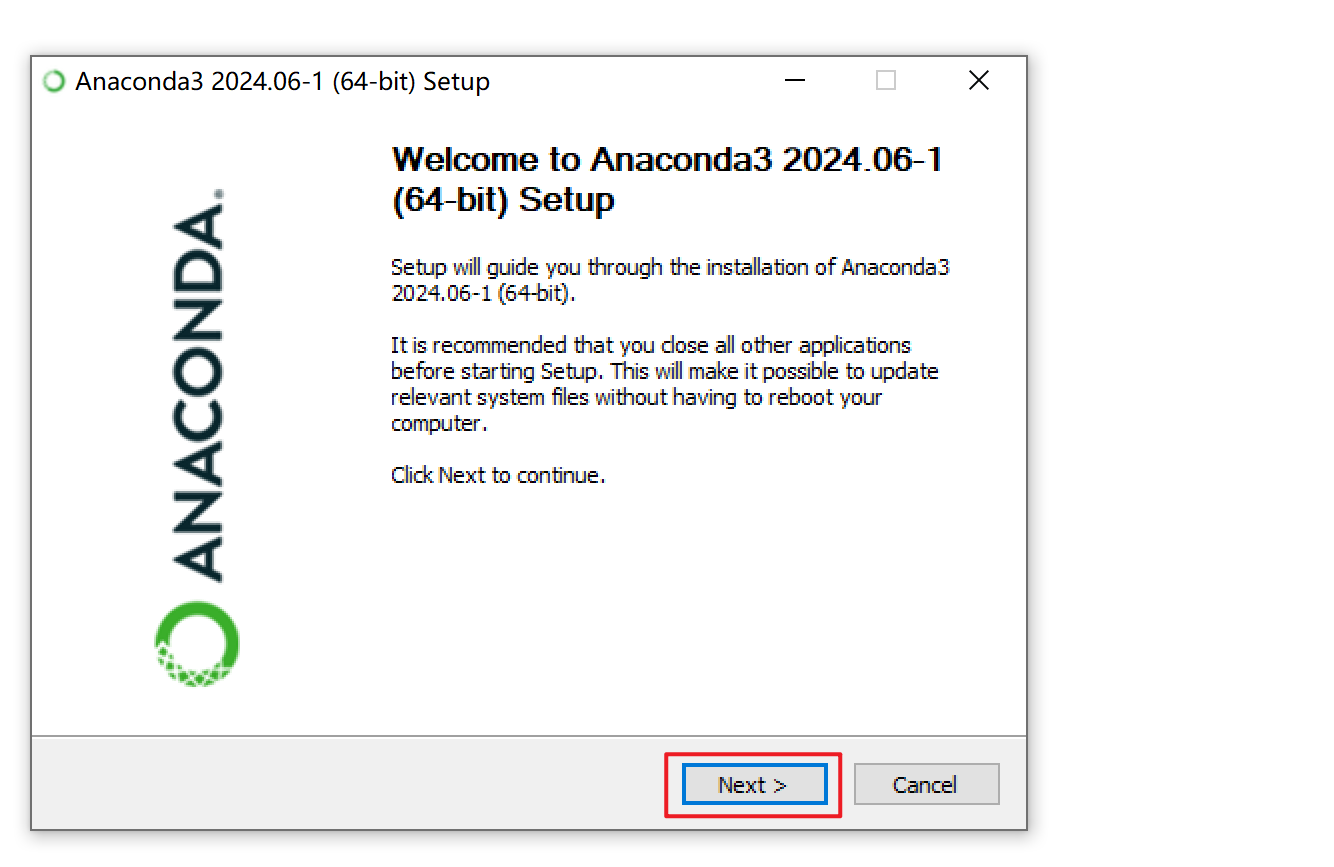
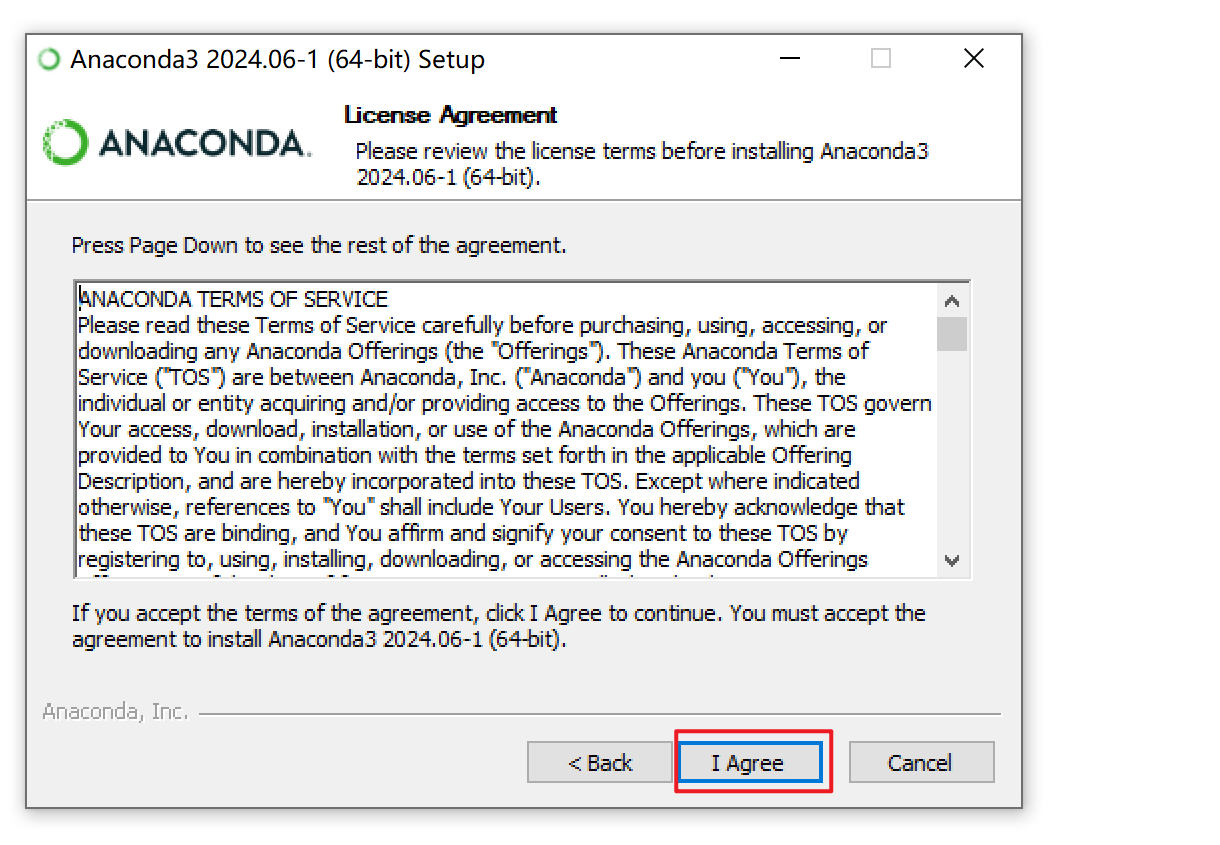
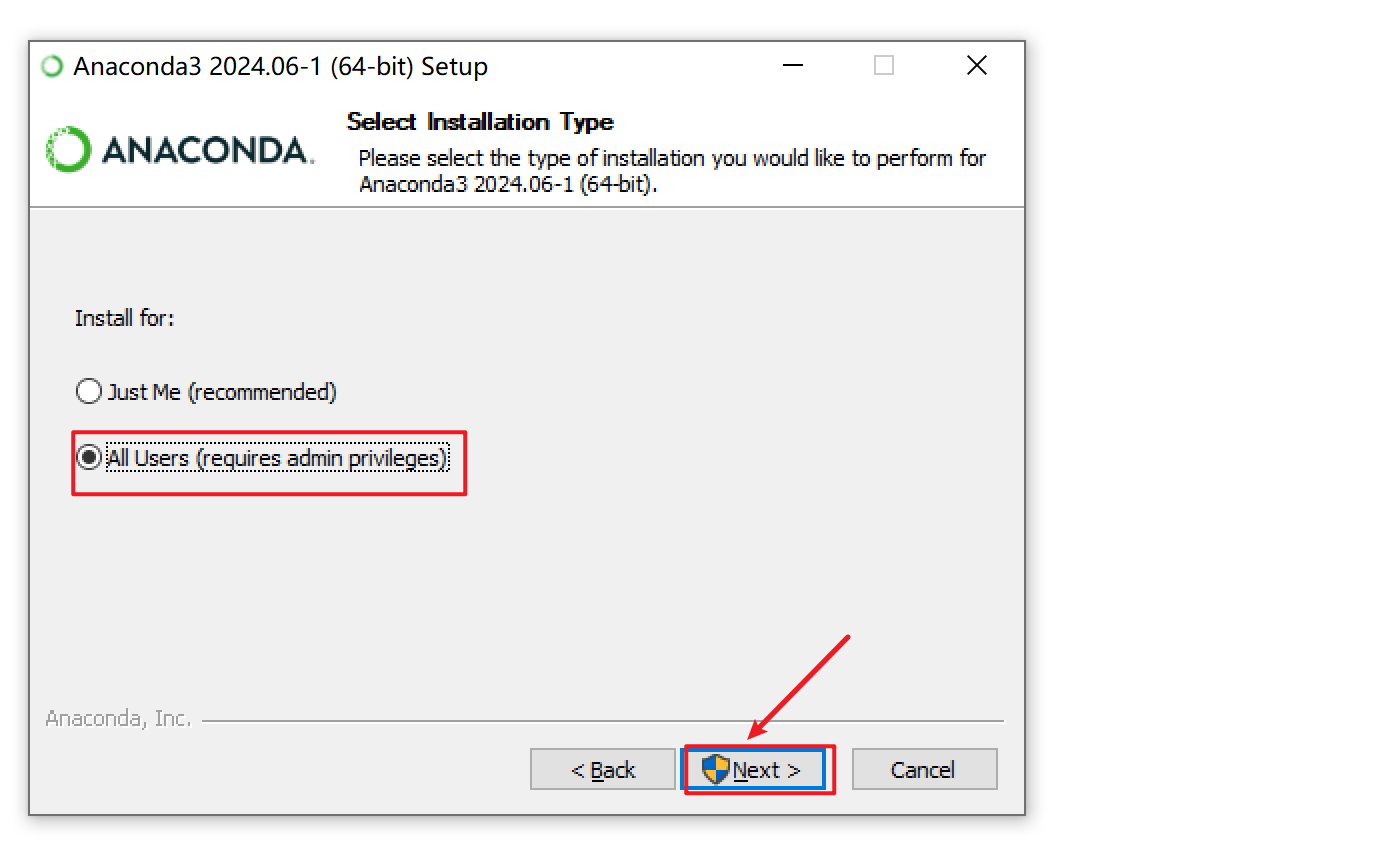
2 选择为所有人安装
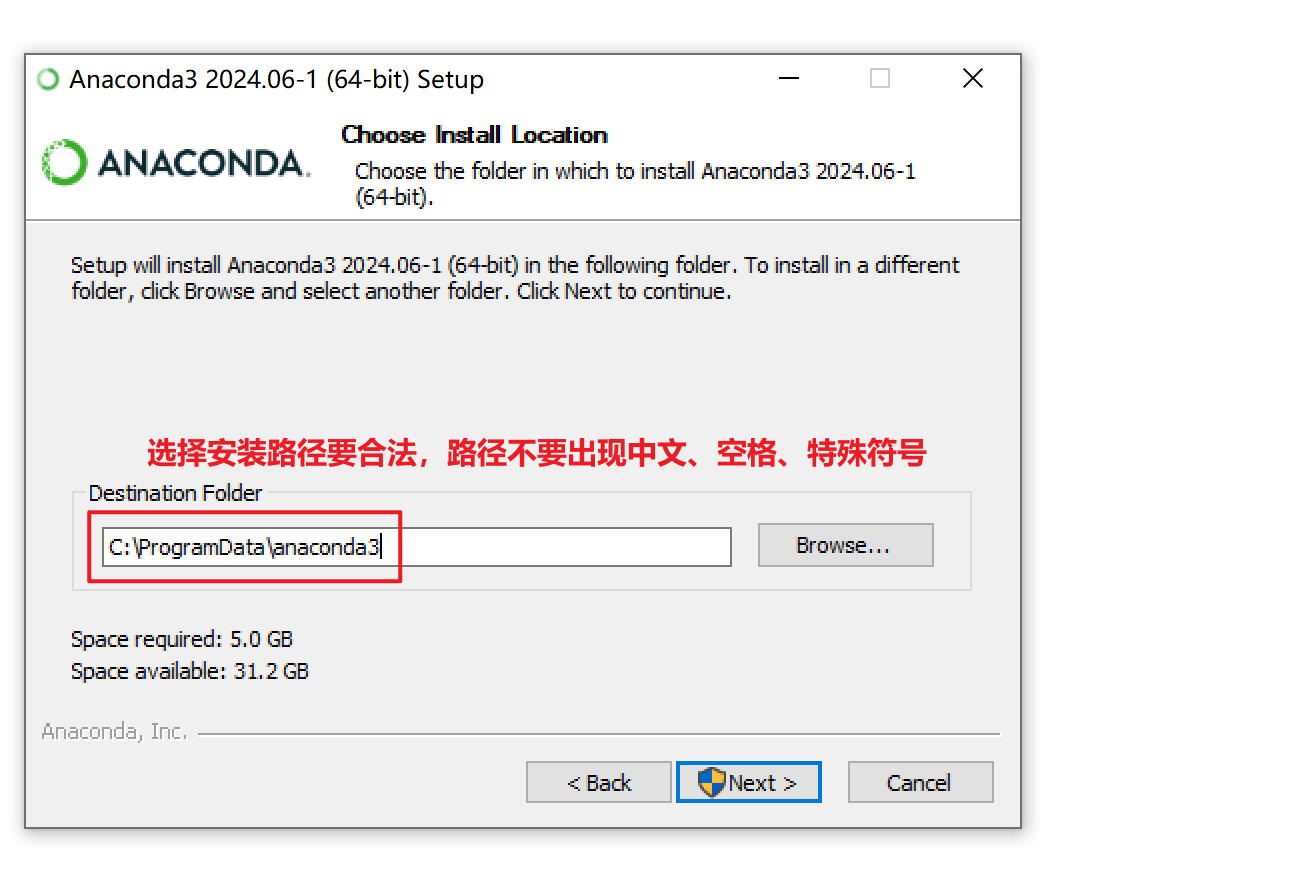
3 运行安装包,建议安装到非 C 盘目录
4 勾选 “Add Anaconda to my PATH environment variable”(可选,方便命令行调用)
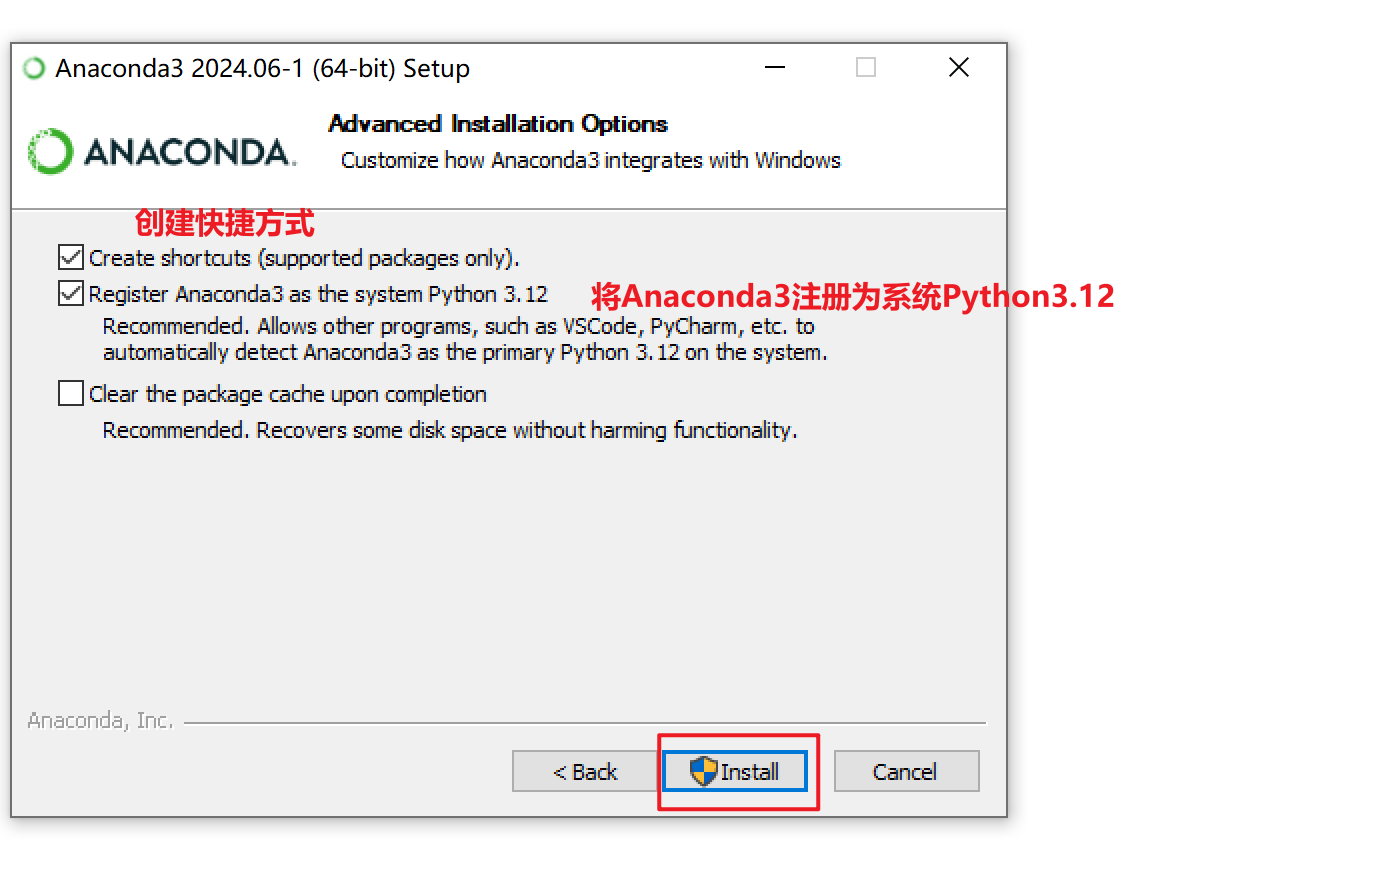
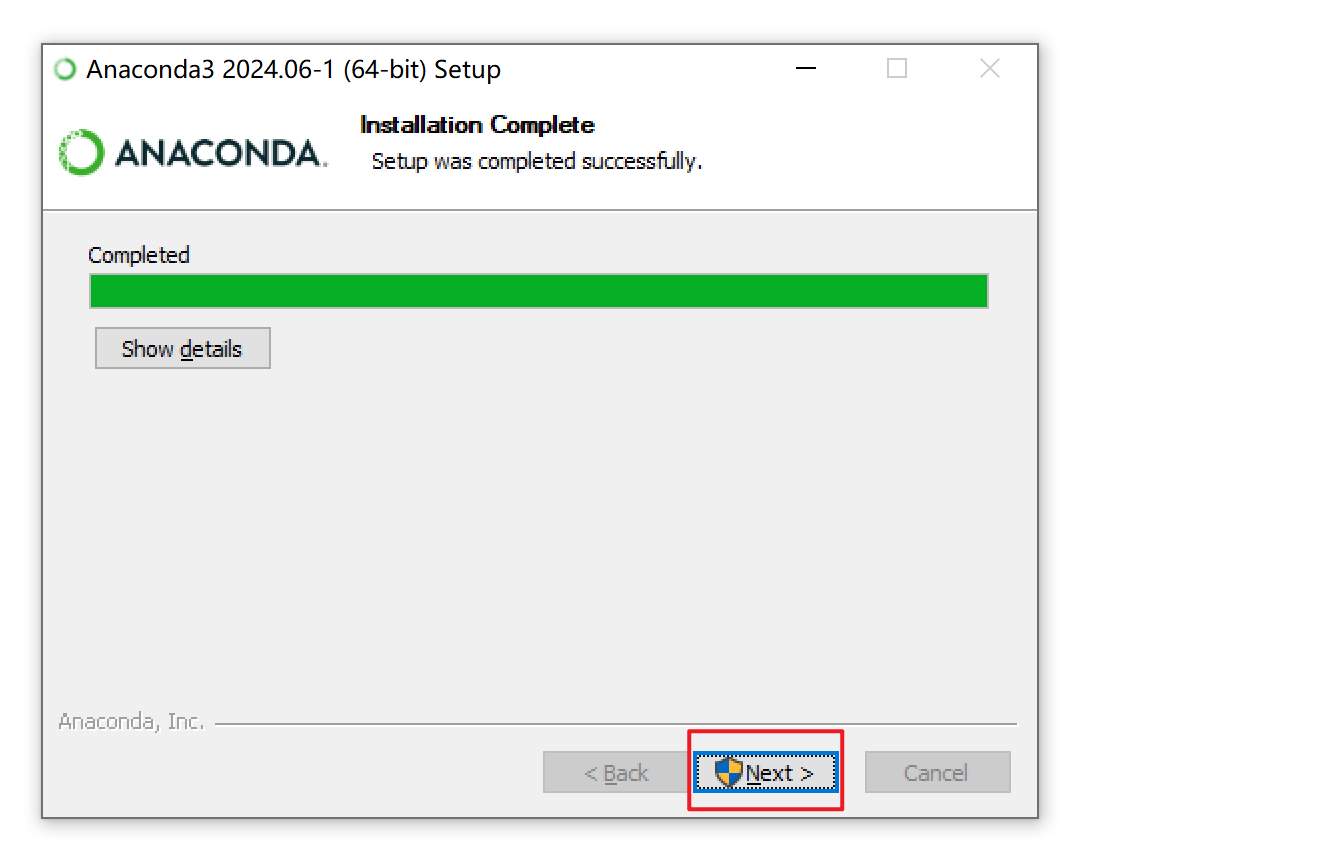
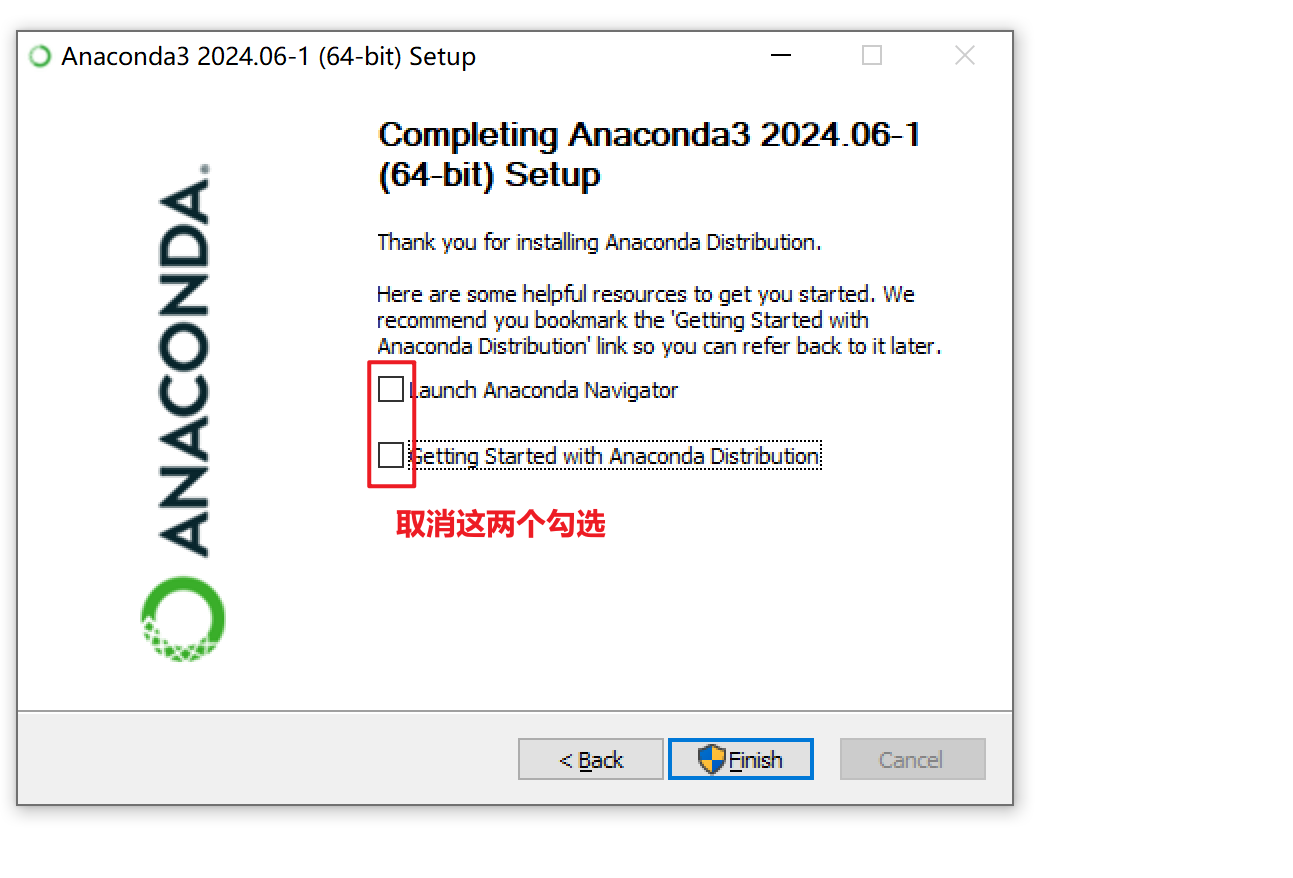
5 等待安装完成,验证:
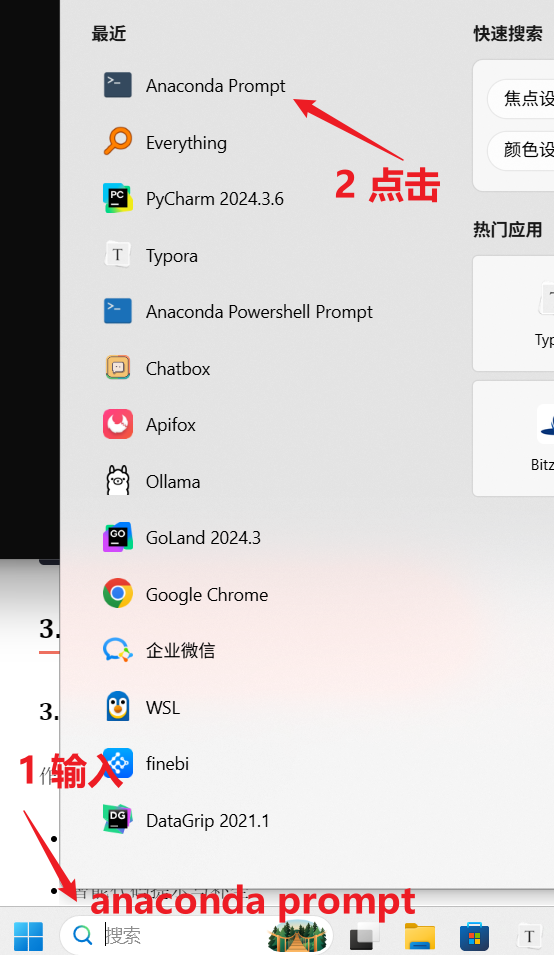
conda -V  # 查看conda版本
python -V # 查看Python版本
配置环境变量
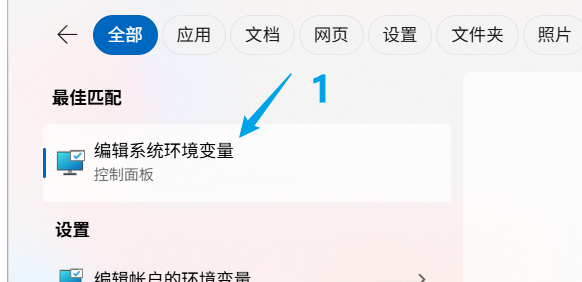
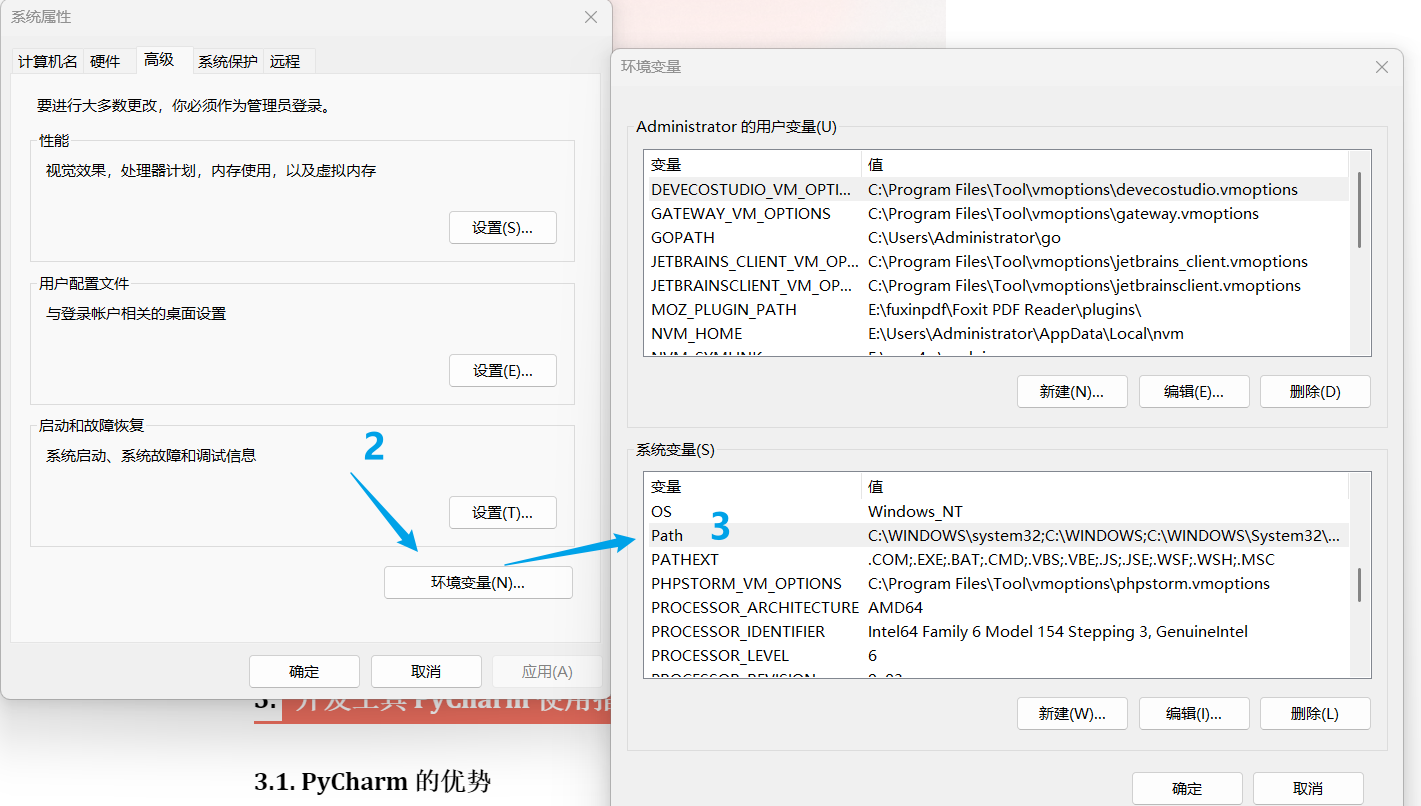
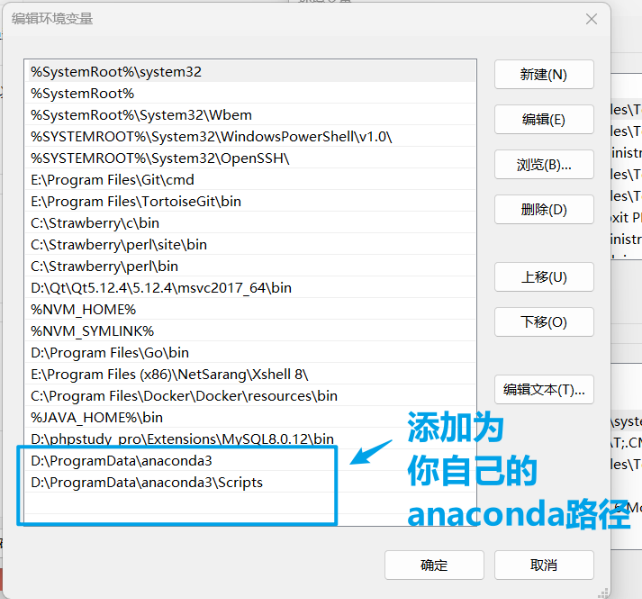
为了可以在cmd中使用Python, 建议去系统环境变量中配置
PyCharm 使用指南
PyCharm 的优势
作为 Python 专用 IDE,PyCharm 提供:
- 项目管理与代码组织
- 智能代码提示与补全
- 语法高亮与错误检测
- 断点调试与性能分析
- 内置版本控制(Git/SVN)
- 丰富的插件生态
PyCharm 版本选择
现在收费版(专业版)和免费版统一下载,免费版可以供个人使用,如果想升级收费版,需要购买激活码
PyCharm 安装与配置
(1)下载安装
官网地址:https://www.jetbrains.com/pycharm/download/
安装步骤:
- 下载对应系统版本的社区版
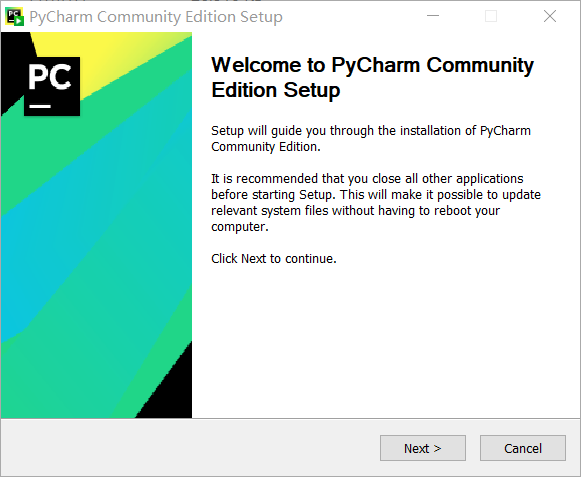
双击exe安装
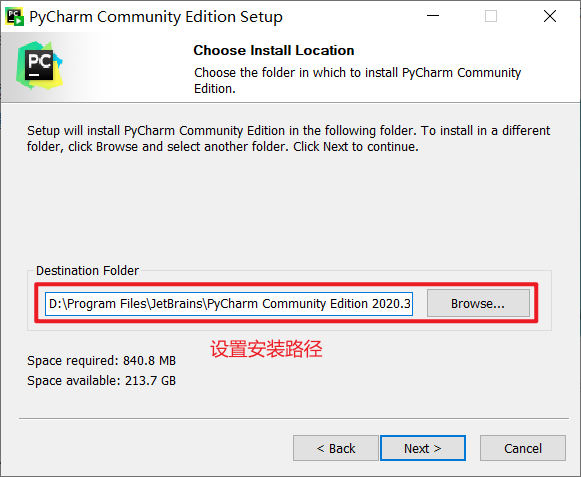
- 选择非 C 盘安装路径
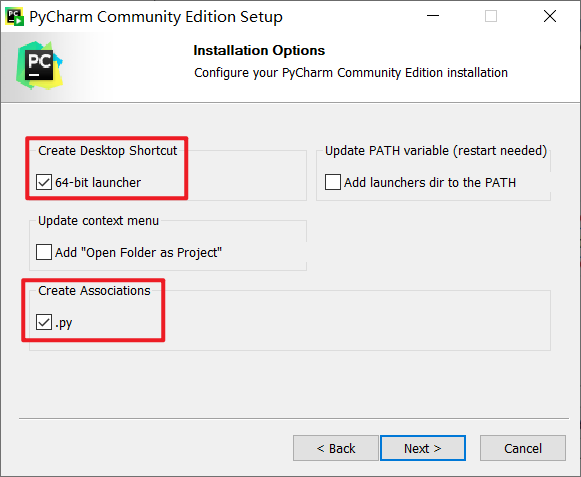
- 勾选 “Create desktop shortcut” 和 “.py file association”
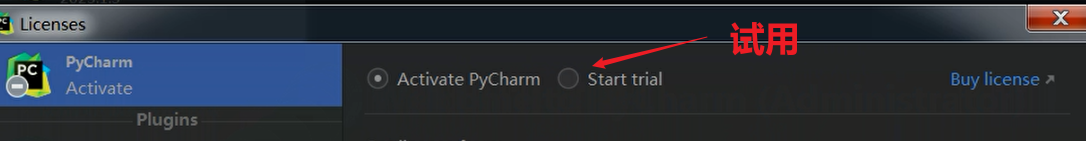
选择试用
(2)核心操作
① 创建项目
- 打开 PyCharm,点击 “New Project”
- 设置项目名称与路径(非 C 盘)
- 选择 Python 解释器(Anaconda 或系统 Python)
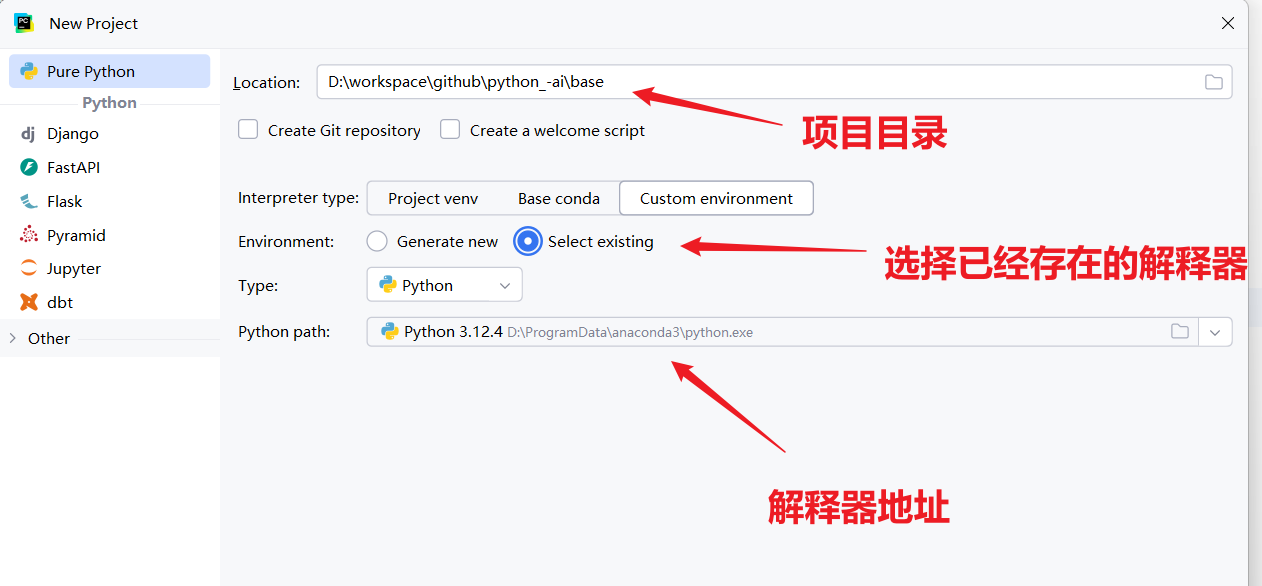
- 点击 “Create” 完成创建
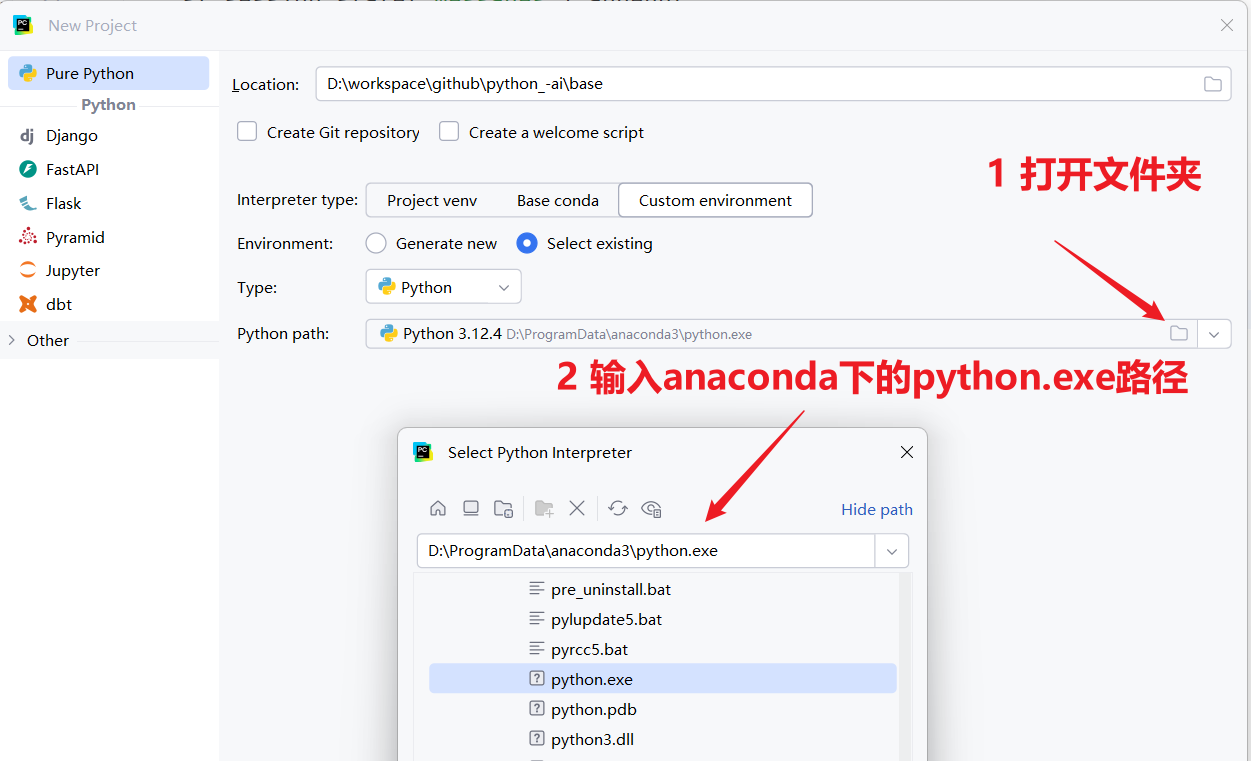
ps:
如果找不到解释器,则打开目录输入解释器路径即可
② 新建文件与编写代码
- 右键项目根目录 → New → Python File
- 输入文件名(如 hello_world)
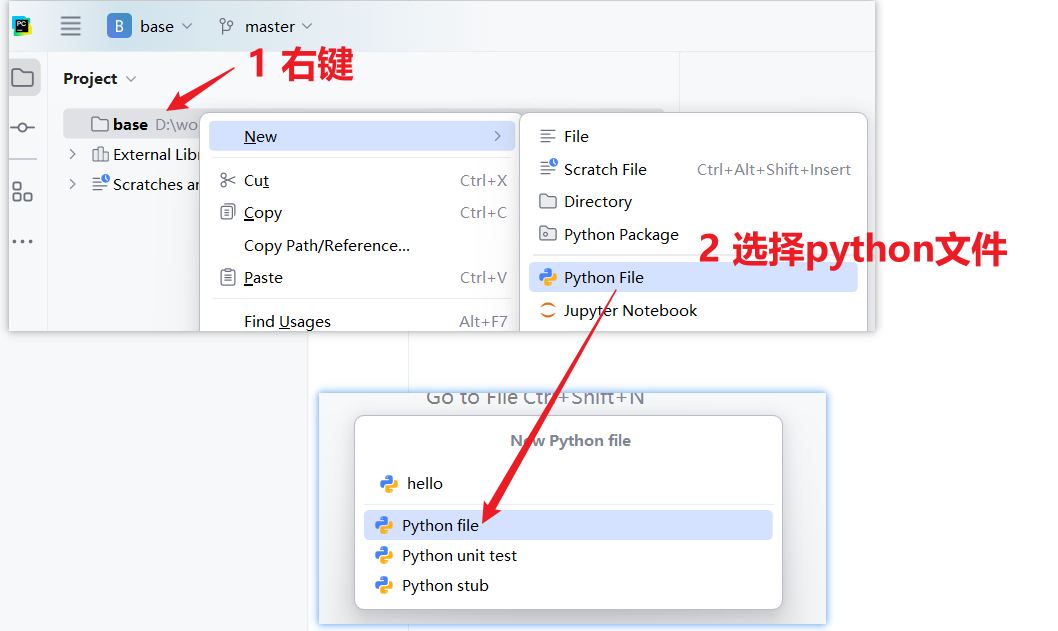
- 编写入门代码:
# 第一个Python程序
print("Hello Python!")
③ 运行代码
- 方式 1:右键代码编辑区 → Run ‘文件名’
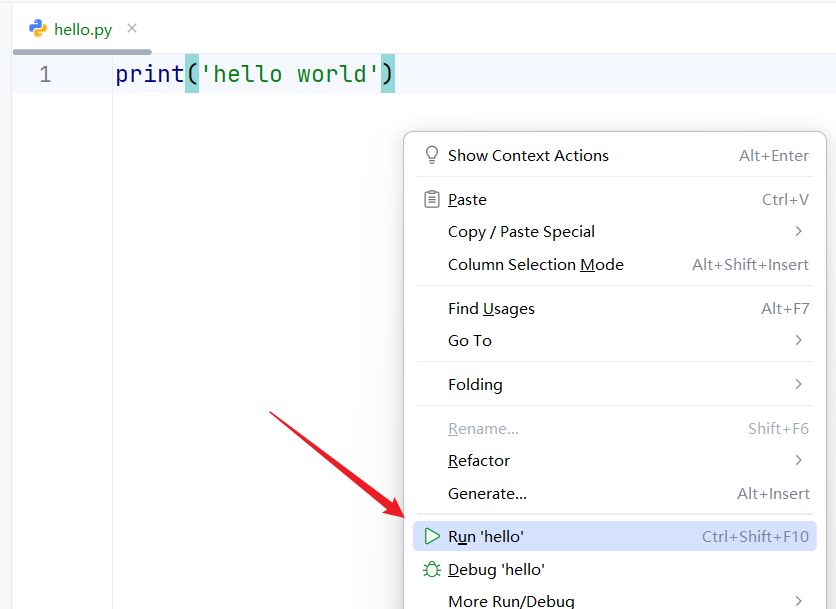
- 方式 2:点击代码右上角的运行按钮
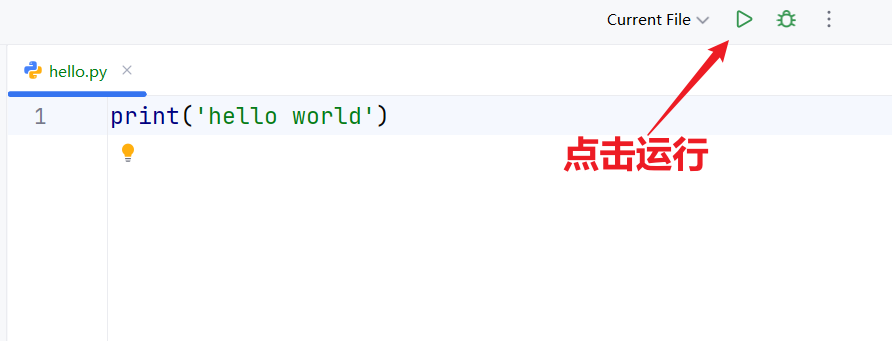
- 方式 3:快捷键 Shift+F10
④ 个性化设置
- 主题设置:File → Settings → Appearance & Behavior → Appearance
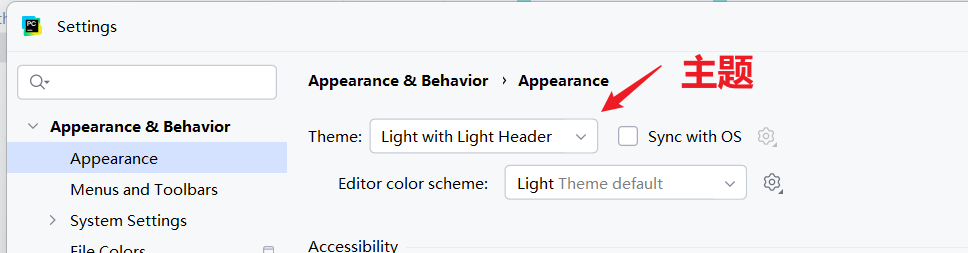
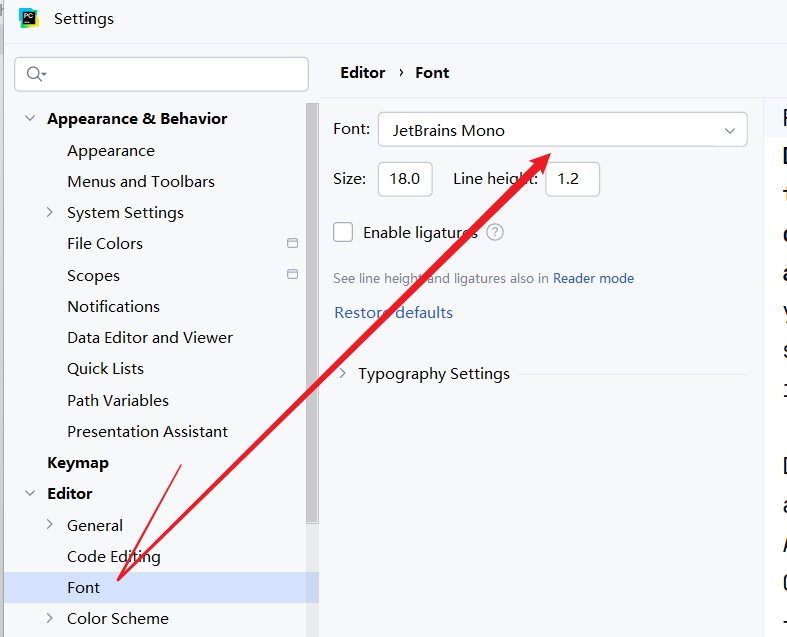
- 字体设置:File → Settings → Editor → Font(建议字号 14-16,字体 Consolas / 等线)
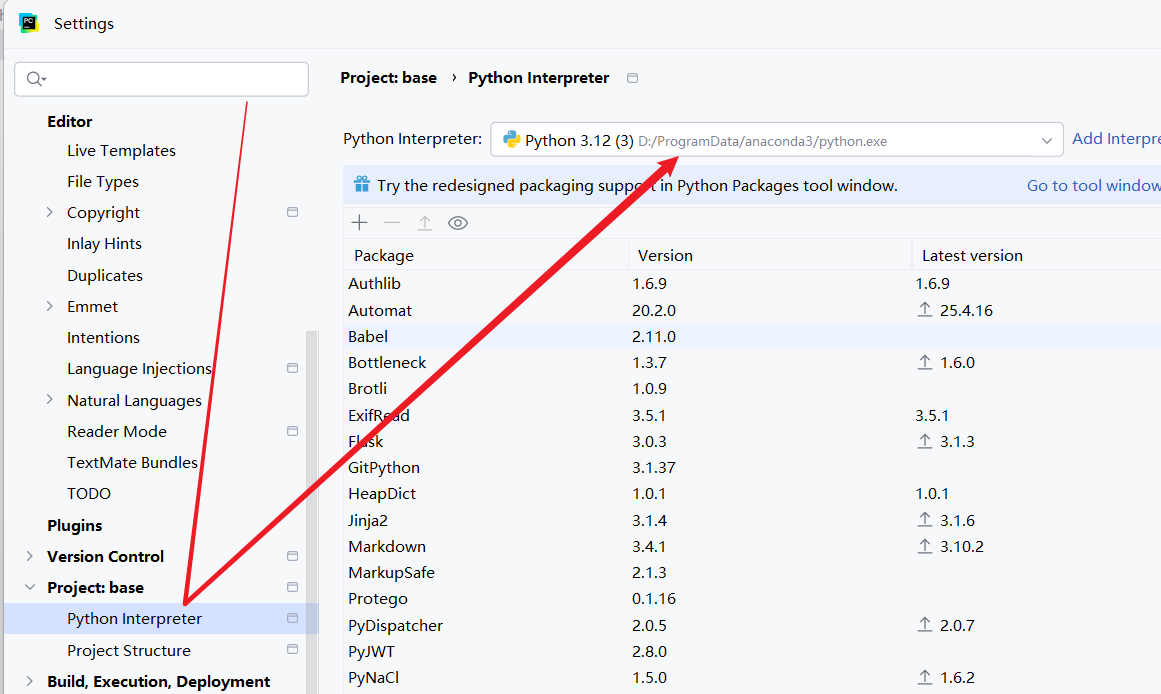
- 解释器切换:File → Settings → Project: 项目名 → Python Interpreter
⑤ 常用快捷键
| 快捷键 | 功能 |
|---|---|
| Ctrl+S | 保存代码 |
| Ctrl+/ | 快速注释 / 取消注释 |
| Ctrl+D | 复制当前行 |
| Ctrl+Z | 撤销操作 |
| Ctrl+Y | 恢复撤销 |
| Ctrl+Alt+L | 格式化代码 |
| Shift+F10 | 运行代码 |
| F9 | 断点调试 |
变量和控制逻辑
注释规范
注释是代码的说明文档,解释器不会执行注释内容,核心作用是提高代码可读性。
(1)单行注释
以<font style="color:rgb(0, 0, 0);">#</font>开头,注释单行内容:
# 这是单行注释(推荐写在代码上方)
print("Hello World")  # 这是行尾注释(建议保留2个空格)
(2)多行注释
使用三引号("""或''')包裹多行内容:
"""
这是多行注释
适用于:
1. 函数/类的功能说明
2. 大段代码的逻辑解释
3. 临时注释多行代码
"""
'''
单引号三引号同样支持多行注释
'''
print("多行注释演示")
变量的定义与使用

(1)变量的本质
变量是存储数据的临时容器,程序运行过程中值可动态修改。
(2)定义语法
# 变量名 = 变量值(等号两侧保留1个空格)
age = 18  # 整数类型
name = "张三"  # 字符串类型
score = 98.5  # 浮点数类型
(3)命名规则
:::color4
强制规则
- 仅能包含字母、数字、下划线(_)
- 不能以数字开头
- 严格区分大小写(age 和 Age 是不同变量)
- 不能使用 Python 关键字(如 if、for、while)
:::
推荐规范

:::color2
- 见名知义(如 user_name 而非 a1)
- 多个单词命名:
- 小驼峰:userName(第二个单词首字母大写)
- 下划线:user_name(推荐,Python 官方风格)
- 大驼峰:UserName(类名专用)
:::
(4)变量的数据类型

Python 是动态类型语言,变量类型由赋值的内容决定:
| 类型 | 说明 | 示例 |
|---|---|---|
| 整数(int) | 无小数的数字 | age = 20 |
| 浮点数(float) | 带小数的数字 | price = 19.9 |
| 字符串(str) | 文本内容(单 / 双引号包裹) | name = “Python” |
| 布尔值(bool) | 逻辑值(True/False) | is_ok = True |
| 列表(list) | 有序可变集合 | nums = [1,2,3] |
| 元组(tuple) | 有序不可变集合 | info = (“张三”, 20) |
| 字典(dict) | 键值对集合 | student = {“name”:“李四”, “age”:19} |
(5)类型检测
# 方法1:type()函数
age = 18
print(type(age))  # <class 'int'>

# 方法2:isinstance()函数(推荐)
print(isinstance(age, int))  # True
print(isinstance(age, str))  # False
输入与输出

1️⃣:f-string(Python3.6+,推荐)

name = "李四"
age = 20
score = 95.5
# 基础用法
print(f"姓名:{name},年龄:{age},成绩:{score}")
# 格式控制(保留2位小数)
print(f"成绩:{score:.2f}")
# 数字补零(6位宽度)
print(f"学号:{1:06d}")  # 输出:000001
2️⃣:format() 方法
print("姓名:{},年龄:{}".format(name, age))
# 指定位置
print("年龄:{1},姓名:{0}".format(name, age))
# 格式控制
print("成绩:{:.2f}".format(score))
3️⃣**:% 占位符(兼容旧版本)**
print(“姓名:%s,年龄:%d,成绩:%.2f” % (name, age, score))
(2)转义字符
| 转义符 | 功能 |
|---|---|
| \n | 换行 |
| \t | 制表符(4 个空格) |
| 反斜杠本身 | |
| " | 双引号 |
| ' | 单引号 |
示例:
print("姓名:{}\t年龄:{}\n成绩:{:.2f}".format(name, age, score))
# 自定义print结束符(默认\n)
print("Hello", end=" ")
print("Python")  # 输出:Hello Python
(3)输入函数 input()
获取用户从键盘输入的内容,所有输入均为字符串类型:
# 基础用法
name = input("请输入您的姓名:")
age = input("请输入您的年龄:")
print(f"您输入的姓名:{name},年龄:{age}")

# 带提示的输入
phone = input("请输入您的手机号:")
print(f"手机号:{phone},类型:{type(phone)}")
数据类型转换

当需要对输入的字符串进行数值运算时,需进行类型转换:
| 函数 | 功能 | 示例 |
|---|---|---|
| int(x) | 转换为整数 | int(“100”) → 100 |
| float(x) | 转换为浮点数 | float(“9.9”) → 9.9 |
| str(x) | 转换为字符串 | str(18) → “18” |
| eval(x) | 执行字符串表达式 | eval(“1+2”) → 3 |
示例:超市收银系统
# 输入商品信息
product_name = input("请输入商品名称:")
price_str = input("请输入商品单价:")
count_str = input("请输入购买数量:")

# 类型转换
price = float(price_str)
count = int(count_str)

# 计算总价
total = price * count

# 输出结果
print(f"您购买了{product_name},单价:{price:.2f}元,数量:{count}件,总价:{total:.2f}元")
运算符

(1)算术运算符
| 运算符 | 描述 | 示例 |
|---|---|---|
| + | 加法 | 10 + 20 → 30 |
| - | 减法 | 20 - 10 → 10 |
| * | 乘法 | 10 * 20 → 200 |
| / | 除法(返回浮点数) | 20 / 10 → 2.0 |
| // | 整除(向下取整) | 21 // 10 → 2 |
| % | 取模(余数) | 21 % 10 → 1 |
| ** | 幂运算 | 2 ** 3 → 8 |
示例:
a = 10
b = 3
print(f"{a} + {b} = {a + b}")    # 13
print(f"{a} - {b} = {a - b}")    # 7
print(f"{a} * {b} = {a * b}")    # 30
print(f"{a} / {b} = {a / b}")    # 3.3333333333333335
print(f"{a} // {b} = {a // b}")  # 3
print(f"{a} % {b} = {a % b}")    # 1
print(f"{a} ** {b} = {a ** b}")  # 1000
(2)赋值运算符
| 运算符 | 描述 | 示例 |
|---|---|---|
| = | 基础赋值 | x = 10 |
| += | 加后赋值 | x += 5 → x = x + 5 |
| -= | 减后赋值 | x -= 5 → x = x - 5 |
| *= | 乘后赋值 | x *= 5 → x = x * 5 |
| /= | 除后赋值 | x /= 5 → x = x / 5 |
| //= | 整除后赋值 | x //= 5 → x = x // 5 |
| %= | 取模后赋值 | x %= 5 → x = x % 5 |
| **= | 幂后赋值 | x = 5 → x = x ** 5 |
(3)比较运算符(返回布尔值)
| 运算符 | 描述 | 示例 |
|---|---|---|
| == | 等于 | 10 == 10 → True |
| != | 不等于 | 10 != 20 → True |
| > | 大于 | 20 > 10 → True |
| < | 小于 | 10 < 20 → True |
| >= | 大于等于 | 20 >= 10 → True |
| <= | 小于等于 | 10 <= 20 → True |
(4)逻辑运算符
| 运算符 | 描述 | 示例 |
|---|---|---|
| and | 逻辑与(都真才真) | (10>5) and (20>10) → True |
| or | 逻辑或(有真就真) | (10>5) or (20<10) → True |
| not | 逻辑非(取反) | not (10>5) → False |
条件判断(if 语句)
(1)核心作用
根据条件表达式的布尔结果(True/False),执行不同的代码块,实现程序的分支逻辑,是程序实现 “判断” 能力的核心语法。

(2)基本语法规则
:::color4
- Python 中用 缩进(4 个空格 / 制表符) 划分代码块,而非大括号,缩进必须统一
- 条件表达式后必须加冒号 :
- 条件表达式可结合比较运算符、逻辑运算符组合使用
:::
(3)四种基本用法
① 单分支(if)
适用场景:满足条件则执行某段代码,不满足则跳过
# 语法
if 条件表达式:
    满足条件时执行的代码块(缩进)

# 示例:判断是否成年
age = 19
if age >= 18:
    print("你已成年,可独立出行")
② 双分支(if-else)
适用场景:二选一,满足条件执行 A 代码块,不满足执行 B 代码块
# 语法
if 条件表达式:
    满足条件执行的代码块
else:
    不满足条件执行的代码块

# 示例:判断是否成年
age = int(input("请输入你的年龄:"))
if age >= 18:
    print("你已成年,可观看此电影")
else:
    print("你未成年,需由监护人陪同")
③ 多分支(if-elif-else)

适用场景:多个条件依次判断,满足某个条件则执行对应代码块,后续条件不再判断;所有条件都不满足则执行 else
# 语法
if 条件表达式1:
    满足条件1执行的代码块
elif 条件表达式2:
    满足条件2执行的代码块
elif 条件表达式3:
    满足条件3执行的代码块
...
else:
    所有条件都不满足时执行的代码块

# 示例:成绩评级
score = float(input("请输入你的考试成绩:"))
if score >= 90:
    print("成绩评级:优秀")
elif score >= 80:
    print("成绩评级:良好")
elif score >= 70:
    print("成绩评级:中等")
elif score >= 60:
    print("成绩评级:及格")
else:
    print("成绩评级:不及格,需要补考")
④ 嵌套分支(if 内部嵌套 if/if-else)
适用场景:主条件满足后,需要再判断细分条件

# 示例:判断是否能参加驾照考试
age = int(input("请输入你的年龄:"))
if age >= 18:
    print("你满足年龄要求,可报名驾照考试")
    height = float(input("请输入你的身高(cm):"))
    if height >= 150:
        print("身高符合要求,可正常报名")
    else:
        print("身高未达到要求,无法报名")
else:
    print("年龄未达标,无法报名驾照考试")
(4)条件表达式的高级用法
- 结合逻辑运算符实现复杂条件
# 示例:判断是否为工作日的工作时间
hour = int(input("请输入当前小时数(0-23):"))
weekday = input("请输入是否为工作日(是/否):")
if weekday == "是" and 9 <= hour <= 18:
    print("当前是工作时间,请专注工作")
else:
    print("当前是非工作时间,可休息")
- 三元表达式(简化单 / 双分支)语法:
结果1 if 条件表达式 else 结果2(满足条件返回结果 1,否则返回结果 2)

# 示例:简化判断成年与否
age = 20
result = "成年" if age >= 18 else "未成年"
print(f"你是:{result}")

# 等价于原双分支代码
if age >= 18:
    result = "成年"
else:
    result = "未成年"
(5)常见易错点

- 忘记写冒号 :条件表达式和 else/elif 后必须加冒号,否则语法报错
- 缩进不统一:同一代码块的缩进必须一致(要么全 4 个空格,要么全制表符)
- 把赋值号 =当成等于号 ==:条件判断中判断相等必须用
==,=是赋值,会导致逻辑错误
# 错误写法
if age = 18:  # 赋值操作,非判断,直接报错
    print("成年")

# 正确写法
if age == 18:
    print("刚成年")
- 多分支中条件顺序错误:多分支是依次判断,范围大的条件不能写在前面
# 错误写法:score>=60写在前面,会导致80+的成绩也判断为"及格"
score = 85
if score >= 60:
    print("及格")
elif score >= 80:
    print("良好")

# 正确写法:从范围小的条件开始判断
if score >= 80:
    print("良好")
elif score >= 60:
    print("及格")
综合实战案例

案例 1:简易成绩管理系统(含条件判断)
"""
简易成绩管理系统
功能:
1. 输入学生姓名和三门科目成绩
2. 计算总分和平均分
3. 根据平均分进行成绩评级
4. 格式化输出所有信息
"""

# 输入学生信息
student_name = input("请输入学生姓名:")
chinese_str = input("请输入语文成绩:")
math_str = input("请输入数学成绩:")
english_str = input("请输入英语成绩:")

# 类型转换(处理输入的字符串,转为浮点数)
chinese = float(chinese_str)
math = float(math_str)
english = float(english_str)

# 计算总分和平均分
total_score = chinese + math + english
avg_score = total_score / 3

# 条件判断:根据平均分评级
if avg_score >= 90:
    grade = "优秀"
elif avg_score >= 80:
    grade = "良好"
elif avg_score >= 70:
    grade = "中等"
elif avg_score >= 60:
    grade = "及格"
else:
    grade = "不及格"

# 格式化输出结果
print("=" * 40)
print(f"学生姓名:{student_name}")
print(f"语文成绩:{chinese:.1f}分")
print(f"数学成绩:{math:.1f}分")
print(f"英语成绩:{english:.1f}分")
print(f"总成绩:{total_score:.1f}分")
print(f"平均成绩:{avg_score:.1f}分")
print(f"成绩评级:{grade}")
print("=" * 40)
案例 2:班级活动费用分摊系统(运算符 + 输入输出 + 条件判断)
"""
班级活动费用分摊系统
功能:
1. 输入参与人数和活动总花费
2. 额外收取10%组织管理费,计算最终总费用
3. 判断人数是否合法(至少1人)
4. 计算每人需要分摊的金额并输出
"""

# 输入并转换数据类型
total_people = int(input("请输入参与活动人数:"))
total_cost = float(input("请输入活动总花费(元):"))

# 条件判断:人数是否合法
if total_people < 1:
    print("人数输入错误,至少1人!")
else:
    # 计算含组织管理费的总费用和人均费用
    manage_fee = total_cost * 0.1  # 10%组织管理费
    final_total = total_cost + manage_fee
    per_person = final_total / total_people

    # 格式化输出
    print("=" * 30)
    print(f"原始活动花费:{total_cost:.2f}元")
    print(f"10%组织管理费:{manage_fee:.2f}元")
    print(f"最终总费用:{final_total:.2f}元")
    print(f"参与人数:{total_people}人")
    print(f"每人需分摊:{per_person:.2f}元")
    print("=" * 30)
循环控制
Python中循环的介绍
什么是循环现实生活中,也有很多循环的应用场景:
(1)老师批改作业:拿起作业本→查看答案→批改打分→放回作业本,重复以上过程,直到所有学生的作业都批改完了
(2)收银员收款:接过顾客商品→扫码计价→收取钱款→打印小票,重复以上过程,直到所有排队顾客都完成付款。
(3)环卫工人扫地:拿起扫帚→清扫路面→收集垃圾→移动到下一段路面,重复以上过程,直到负责区域清扫完毕。
(4)学生晨读:打开课本→朗读段落→标记重点→继续朗读,重复以上过程,直到晨读时间结束。
以上场景都有一个共同的特点:有条件地重复地做一件事,每一次做的事情不同但类似。
程序是为了解决实际问题的,实际问题中存在着重复动作,那么程序中也应该有相应的描述,这就是循环。
循环的作用是什么?答:让代码高效的重复执行,避免重复编写大量相同或相似的代码,提升编程效率。
## while循环语法及其应用 ### while循环的基本语法 ```python # Step1: 定义一个计数器(初始化一个计数器) i = 0或1 # Step2: 编写while循环结构 while 循环条件(判断 计数器 是否达到了目标位置): 循环体1 循环体2 ... # Step3: 在循环内部更新计数器 i = i + 1 或 i += 1 ```普及小知识:在计算机程序中,计数器大部分都是从0开始的,少数场景会从1开始,根据需求灵活选择。
:::color2
总结:while循环三步走
① 初始化计数器
② 编写循环条件(判断计数器是否达到了目标位置)
③ 在循环内部更新计数器
:::
# 演示 while循环
"""
while 判断条件:
    # 当条件满足 需要执行的内容

说明:
    while: 实现循环操作的关键字
    条件判断: 是否进入循环的依据
        当条件成立, 就执行循环里面的内容, 条件一直成立 就一直循环执行内部的代码 直到条件不成立
"""

# 需求: 请循环 打印 5次  Python真有趣
# 1- 定义计数器
num = 1

# 2- 编写循环操作
while num <= 5:
    # 2.1 执行循环的主体代码
    print("Python真有趣")

    # 2.2 更新计数器 +1
    # num = num + 1
    num += 1
while循环流程图:

while循环案例
案例1:使用while循环求1…50的和
分析:定义一个while循环,让其可以帮助我们计算 1 + 2 + 3 + 4 + 5 … + 50,结果:1275
# 需求: 求 1~50的和
# 思路: 1- 需要对 1~50进行遍历(循环)  2- 每循环一个 就要对其进行累加计算(在while循环外部定义一个初试累加变量)

# 如何进行 1 ~ 50 循环呢
# 第一步: 定义计数器
i = 1

# 第二步: 编写循环操作
# 2.1 定义一个累加求和的变量
sum_total = 0

while i <= 50:
    # 2.2 循环的代码块
    sum_total = sum_total + i
    # 第三步: 更新计数器
    i += 1

print(sum_total)
案例2:求1~50之间,所有奇数的和
什么是奇数:所谓的奇数,就是不能被2整除的数字,数学中可以使用2n+1来表示奇数。(Python代码 => if 数值 % 2 != 0 代表它是一个奇数)
知识点:在while循环中,我们还可以结合if进行判断,筛选出符合条件的数据。
# 需求2: 求1~50之间,所有奇数的和  不能被2 整除的 就是奇数(余数不为0)
# 思路: 1- 需要对 1~50进行遍历(循环)  2- 每循环一个 先判断是否为奇数, 如果是对其进行累加计算(在while循环外部定义一个初试累加变量)

# 1- 定义计数器
i = 1

# 2- 编写循环操作
# 2.2.1 先定义一个累加的初始变量
sum_odd = 0
while i <= 50:
    # 循环的主体要执行的代码块
    # 2.1 判断是否为奇数
    if i % 2 != 0:
        # 2.2 如果是奇数, 进行累加
        # 2.2.2 执行累加
        sum_odd += i

    # 3- 更新计数器
    i += 1

print(sum_odd)
循环中的两大关键词
两大关键词
在Python循环中,经常会遇到两个常见的关键词:break 与 continue
:::danger
break:代表终止整个循环结构,一旦执行,直接退出循环,不再执行后续循环体内容。
continue:代表中止当前本次循环,跳过本次循环剩余内容,继续执行下一次循环。
:::
举例:老师检查6本作业,检查完第一本,检查第二本…,这里"检查作业"的动作是不是重复执行?

场景一:如果检查过程中,发现第三本作业空白未写,无需再检查后续作业,直接停止检查,这里就是break控制循环流程,即终止此循环。

场景二:如果检查过程中,发现第三本作业有少量错误,标注错误后跳过这本,继续检查第四本作业,这里就是continue控制循环流程,即退出当前一次循环继而执行下一次循环代码。
break关键字
场景一:如果检查过程中,发现第三本作业空白未写,无需再检查后续作业,直接停止检查,这里就是break控制循环流程,即终止此循环。
# 演示 break:  实现中断循环 直接退出循环操作
# 需求: 遍历从  1 ~ 50 , 要求 一旦值能够被15整除(除 15  余数为 0) 立即退出循环
# 1- 定义计数器
i = 1

# 2- 编写循环
while i <= 50:
    # 循环的主体内容
    # 如果值能够被15整除, 退出循环
    if i % 15 == 0:
        break

    print(i)

    # 3- 更新计数器
    i += 1

# 退出循环后, 执行后续的代码
print("循环已终止,退出程序")
continue关键字
场景二:如果检查过程中,发现第三本作业有少量错误,标注错误后跳过这本,继续检查第四本作业,这里就是continue控制循环流程,即退出当前一次循环继而执行下一次循环代码。
# 演示 continue:  跳过本次循环, 进入下一次循环

# 需求: 遍历从  1 ~ 50 , 要求 如果遍历的值能够被 6 整除  将该值直接跳过不打印
# 1- 定义计数器
i = 1

# 2- 编写循环
while i <= 50:
    # 循环的主体内容
    # 如果能够被6整除, 将该值跳过 不打印
    if i % 6 == 0:
        # 更新计数器: 必须在continue前更新,否则会出现死循环
        i += 1
        continue

    print(i)

    # 3- 更新计数器
    i += 1

# 退出循环后, 执行后续的代码
print("循环执行完毕")
答:会出现死循环(计数器一直停留在满足continue条件的数值上,永远无法满足循环结束条件),建议使用Debug调试工具观看执行过程。
### 死循环概念 ** 在编程中一个靠自身控制无法终止的程序称为"死循环",死循环会一直占用计算机资源,开发中应尽量避免。**在Python中,我们也可以使用while True来模拟死循环:
# 注意 如果条件永久成立, 那么这个循环也被成为 死循环
while True:
    print("这是一个死循环,按Ctrl+C可强制终止")
while循环案例:猜数字
案例需求
编写一个Python程序,系统提前设定一个1到20之间的固定整数(如12),让用户反复输入数字猜测,每次输入后提示"猜大了"“猜小了"或"猜对了”,直到用户猜对为止,猜对后提示游戏结束,不使用任何异常相关知识。
实现思路
:::color1
① 编写死循环,满足"猜对"条件后终止循环。
② 提前设定一个固定整数(如12)作为答案,无需随机生成(避开未学的random模块)。
③ 让用户输入数字,通过if判断输入数字与答案的大小关系,给出对应提示,猜对则终止循环。
:::
代码实现
# 演示 猜数字游戏(无random、无异常,适合未学相关知识的学生)
# 1- 提前设定固定答案(1~20之间),无需随机生成
answer = 12
# 2- 让用户反复猜测,写死循环方式
print("欢迎来到猜数字游戏!")
print("规则:系统已设定1~20之间的一个整数,猜对即可结束游戏,每次猜测会提示猜大或猜小~")
while True:
    # 2.1 让用户输入猜测的数字(直接转为整数,提示用户输入整数)
    user_guess = int(input("请输入你猜测的1~20之间的整数:"))
    # 2.2 判断猜测结果,给出对应提示
    if user_guess == answer:
        print("恭喜你,猜对了!游戏结束~")
        # 猜对后终止循环
        break
    elif user_guess > answer:
        print("猜大了,再试试小一点的数字!")
    else:
        print("猜小了,再试试大一点的数字!")
扩展: 要求增加限制次数(3次), 并且要提示用户还剩余几次猜测机会: 仅做了解即可, 可以尝试写一写(对理解 while 和 if 很有作用)
# 演示 猜数字游戏(限制次数版,无random、无异常)
# 1- 提前设定固定答案(1~20之间),无需随机生成
answer = 12
# 2- 定义猜测次数(限制3次)
guess_count = 1
# 3- 写死循环,控制猜测次数
print("欢迎来到猜数字游戏!")
print("规则:系统已设定1~20之间的一个整数,你有3次猜测机会,猜对即可获胜~")
while True:
    # 3.1 让用户输入猜测的数字,提示剩余次数
    user_guess = int(input(f"请输入你猜测的1~20之间的整数(剩余{3 - guess_count + 1}次机会):"))
    # 3.2 判断猜测结果,给出对应提示
    if user_guess == answer:
        print(f"恭喜你,猜对了!你在第{guess_count}次就猜对了,游戏结束~")
        break
    elif user_guess > answer:
        print("猜大了,再试试小一点的数字!")
    else:
        print("猜小了,再试试大一点的数字!")
    # 3.3 判断次数是否用完
    if guess_count >= 3:
        print(f"猜测次数已用完!正确答案是{answer},游戏结束~")
        break
    # 计数器+1
    guess_count += 1
for循环基本语法及其应用
for循环基本语法
:::info
for循环结构主要用于(序列 => 字符串、列表、元组、集合以及字典)类型数据的遍历(循环)操作,无需手动定义和更新计数器,使用起来更简洁。
for循环主要用于序列类型数据的循环操作(遍历操作)
另外当循环次数已知的情况,建议使用for循环(比while循环更简洁)。
:::
for 临时变量 in 序列:
    重复执行的代码1
    重复执行的代码2
案例:使用for循环遍历字符串"python"
# 演示: for基本使用
"""
    语法格式:
        for 临时变量 in 序列:
            循环执行的代码块

        注意:
            临时变量的值 其实 就是 序列中每一个元素,循环次数等于序列的长度
"""
# 需求: 遍历一个字符串 :  python
for char in "python":
    print(char)
使用Debug调试以上代码可知:for循环功能非常强大,可以自动判断序列的长度,长度为多少,则for循环就循环多少次。每次循环时,系统会自动将序列中的每个元素赋值给临时变量,赋值完成后,for循环内部会自动更新计数器,向后移动一位,继续循环,直至元素全部循环结束。
range方法(函数)
在Python3中 **<font style="color:#DF2A3F;">range() </font>**函数返回的是一个可迭代对象(类型是对象)
主要作用:用于生成一段连续的整数序列,方便配合for循环使用。
range(stop)
range(start, stop, step)

start: 计数从 start 开始。默认是从 0 开始。例如range(4)等价于range(0, 4);
stop: 计数到 stop 结束,但不包括 stop。例如:range(0,4) 是 [0, 1, 2, 3] 没有 4
step:步长,默认为1。例如:range(0,4) 等价于 range(0, 4, 1)
# 演示 range函数
# 作用: 帮我们生成一个连续的数字, 例如 0~3
# 语法:  range(起始值,结束值,步长)
#  起始值: 默认为  0   结束值: 必填的  在生成序列的时候, 不含结束值  步长: 默认为1 表示 数字与数字之间的间隔
# 需求: 生成 4以内的序列, 并且将每一个值打印出来
for num in range(0,4):
    print(num)
for循环案例
# 需求: 求 1~50 之间 所有的奇数之和
sum_odd = 0
for num in range(1,51):
    if num % 2 != 0:
        sum_odd += num
print(sum_odd)
综合案例:使用for循环实现用户名+密码认证-作业
案例:用for循环实现用户登录
:::info
① 输入用户名和密码
② 判断用户名和密码是否正确(username=‘student’,password=‘python123’)
③ 登录仅有2次机会,超过2次会提示"登录失败,次数已用完"
:::
分析:用户登陆情况有3种:
:::color1
① 用户名错误(此时便无需判断密码是否正确) – 登陆失败
② 用户名正确 密码错误 --登陆失败
③ 用户名正确 密码正确 --登陆成功
:::
# 用户登录案例(for循环版)

# 1- 构建循环, 并且循环只能有 2次
for i in range(0,2):
    # 2: 让用户输入 用户名 和 密码
    user_name = input("请输入用户名:")
    user_pwd = input("请输入密码:")

    # 3: 判断 用户名和密码是否正确
    if user_name == 'student':
        if user_pwd == 'python123':
            print("恭喜您, 登录成功!")
            # 登录成功后, 直接退出循环
            break
        else:
            print(f"您输入的密码不正确, 您还剩余{1-i}次机会")
    else:
        print(f"您输入的用户名不正确, 您还剩余{1-i}次机会")
else:
    # 循环正常结束(未break),说明次数用完
    print("登录失败,次数已用完!")
for循环中的else结构
为什么需要在for循环中添加else结构
循环可以和else配合使用,else下方缩进的代码指的是当循环正常结束之后要执行的代码(即没有被break终止,完整执行完所有循环次数)。
强调:‘正常结束’,非正常结束(如遇到break、程序异常),其else中的代码是不会执行的。
for循环结构中的else结构
基本语法:
for 临时变量 in 序列:
    循环体
else:
    当for循环正常结束后,执行的代码
break关键字对for…else结构的影响
str1 = 'python'
for i in str1:
    if i == 'h':
        print('遇h强制结束循环')
        break
    print(i)
else:
    print('循环正常结束之后执行的代码')
运行结果:只会打印p、y、t,然后打印"遇h强制结束循环",else中的代码不会执行(因为循环被break终止,属于非正常结束)。
continue关键字对for…else结构的影响
str1 = 'python'
for i in str1:
    if i == 'h':
        print('遇h不打印')
        continue
    print(i)
else:
    print('循环正常结束之后执行的代码')
运行结果:打印p、y、t、遇h不打印、o、n,最后打印"循环正常结束之后执行的代码"(continue只是跳过本次循环,循环整体正常结束)。
else结构整体演示
# 演示: for循环结合else情况
"""
    语法:
        for 临时变量 in  序列:
            循环体
        else:
            当循环正常结束后, 需要执行的代码

    如果for循环中,
        通过break退出的循环, 那么就不会执行else语句的内容
        通过continue跳过当前循环, 对于else 不会有影响的
        在循环过程中程序出现异常(程序异常结束), else也不会执行
"""
# 需求: 循环输出从 1~6, 当循环正常结束后, 打印 循环完成
for i in range(1,7):
    # 当循环到3的时候, 强制退出循环(注释后可测试正常情况)
    # if i == 3:
    #     break

    # 当循环到3的时候, 跳过当前循环 进入下一次循环
    # if i == 3:
    #     continue
    # 异常情况(注释后可测试正常情况)
    # 1/0
    print(i)
else:
    print("循环结束了.....")
双层循环
for循环里可以嵌套for循环以及while循环,while循环中也可以嵌套for循环和while循环
for循环嵌套for循环
for 临时变量1 in 序列1:
    for 临时变量2 in 序列2:
        内层循环体
for循环嵌套while循环
for 临时变量1 in 序列1:
    index = 初始值
    while index的判断条件:
        内层循环体
while循环嵌套while循环
index = 初始值
while index的判断条件:
    index2 = 初始值
    while index2的判断条件:
        内层循环体
while循环嵌套for循环
index = 初始值
while index的判断条件:
for 临时变量 in 序列:
    内层循环体
双层循环经常用来控制双层遍历的情况,比如打印九九乘法表
双层循环,如果内层循环使用了break,break只能跳出
它所在的循环,也就是内层循环
'''
演示双层循环实现九九乘法表
'''

'''
双层循环,如果内层循环使用了break,break只能跳出
它所在的循环,也就是内层循环
'''

'''
需求:
实现九九乘法表
思路:
1. 变量row控制行号,row从1到9结束,[1,9]
2. 变量col控制列号,col从1开始回到当前行号结束,[1,row]
3. 用外层循环控制行号的变化,内层循环控制列号的变化
for row in range(1,10):
    for col in range(1,row+1):
        pass
'''
for row in range(1,10):
    for col in range(1,row+1):
        # print(f'当前行号{row},当前列号{col}')
        print(f'{col} * {row} = {row * col}',end='\t')
    # print()默认输出换行符
    print()

print('#'*100)
'''
要求九九乘法表最多只输出到第3列
思路:
col为4的时候结束内层循环即可,外层循环继续
'''
for row in range(1,10):
    for col in range(1,row+1):
        # print(f'当前行号{row},当前列号{col}')
        print(f'{col} * {row} = {row * col}',end='\t')
        # 当col为4的时候结束内层循环,跳转到外层循环
        if col == 4:
            # break只能跳出它所在的循环(离他最近的循环)
            break
    # print()默认输出换行符
    print()
print('#'*100)
基础数据结构
列表及其应用场景

为什么需要列表
思考:有一个人的姓名(LiLei)怎么书写存储程序?答:变量。
思考:如果一个班级50位学生,每个人的姓名都要存储,应该如何书写程序?声明50个变量吗?答:No,我们使用列表就可以了, 列表一次可以存储多个数据。
在Python中,我们把这种数据类型称之为** 列表**。但是在其他的编程语言中,如Java、PHP、Go等等中其被称之为数组。列表的定义
列表序列名称 = [列表中的元素1, 列表中的元素2, 列表中的元素3, ...]

注意: 列表是可变的
案例演示:定义一个列表,用于保存橙子、葡萄以及芒果
fruit_list = ['orange', 'grape', 'mango']
# list列表类型支持直接打印
print(fruit_list)
# 打印列表的数据类型
print(type(fruit_list))  # <class 'list'>
注意:列表可以一次存储多个数据且可以为不同的数据类型

相关操作:
# 演示: 如何定义列表
# 格式: 变量名称 = [元素1,元素2,元素3......]
# 需求: 构建一个列表, 保存 小明 小红 小刚 小丽 四个名字
name_list = ['小明','小红','小刚','小丽']
print(name_list)

# 如何获取列表中某一个元素呢? 与 字符串 一致
print(name_list[0])
print(name_list[1])
print(name_list[2])

# 如何遍历列表呢?
print("-----------------")
# for循环
for name in name_list:
    print(name)

# while循环
print("-----------------")
# 计数器
i = 0

while i < len(name_list):
    print(name_list[i])

    # 更新计数器
    i += 1
列表的相关操作

列表的作用是一次性存储多个数据,程序员可以对这些数据进行的操作有:增、删、改、查。
☆ 查操作
列表在计算机中的底层存储形式,列表和字符串一样,在计算机内存中都占用一段连续的内存地址,我们向访问列表中的每个元素,都可以通过"索引下标"的方式进行获取。
如果我们想获取列表中的某个元素,非常简单,直接使用索引下标:
fruit_list = ['orange', 'grape', 'mango']
# 获取列表中的grape
print(fruit_list[1])
| 函数 | 作用 |
|---|---|
| index() | 指定数据所在位置的下标 |
| count() | 统计指定数据在当前列表中出现的次数 |
| in | 判断指定数据在某个列表序列,如果在返回True,否则返回False |
| not in | 判断指定数据不在某个列表序列,如果不在返回True,否则返回False |
☆ 增操作
| 函数 | 作用 |
|---|---|
| append() | 增加指定数据到列表中 |
| extend() | 列表结尾追加数据,如果数据是一个序列,则将这个序列的数据逐一添加到列表 |
| insert() | 指定位置新增数据 |

☆ 删操作
| 函数 | 作用 |
|---|---|
| del 列表[索引] | 删除列表中的某个元素 |
| pop() | 删除指定下标的数据(默认为最后一个),并返回该数据 |
| remove() | 移除列表中某个数据的第一个匹配项。 |
☆ 改操作
| 函数 | 作用 |
|---|---|
| 列表[索引] = 修改后的值 | 修改列表中的某个元素 |
| reverse() | 将数据序列进行倒叙排列 |
| sort() | 对列表序列进行排序 |
相关功能的演示:
# 演示列表的API
name_list = ['小明', '小红', '小刚', '小丽', '小强', '小芳', '小亮', '小红']
# 查询相关方法:
# 1- index(): 查询指定数据所在位置的下标  如果不存在 直接报错
index = name_list.index("小丽")
print(index)  # 3

# 2- count(): 统计数据在当前列表中出现的次数
count = name_list.count("小红")
print(count)  # 2

# 3- in 和 not in 判断是否存在或不存在
bool = "小刚" in name_list
print(bool)
bool = "小刚" not in name_list
print(bool)

# 增加函数
# 1- append()  增加指定数据到列表中
# 如果 小宇 不在列表中, 请增加到列表中
if "小宇" not in name_list:
    # 能进来, 说明 小宇 不在, 如果不在 添加到列表中
    name_list.append("小宇")

print(name_list)

# 2- extend(): 将一个序列 追加到另一个序列中
# 2.1 先定义一个新的序列
name2_list = ['小浩', '小琪']

# 2.2 将新列表中数据 增加 到 原有列表中
name_list.extend(name2_list)

print(name_list)

# 3- insert() 在指定位置新增数据
name_list.insert(4, '小诺')

print(name_list)

# 删除操作
# 1- del 列表[索引]
del name_list[-1]

print(name_list)

# 2- pop() 删除指定下标的数据, 默认是删除最后一个 并且会返回删除的数据
element = name_list.pop()
print(element)
print(name_list)

element = name_list.pop(2)
print(element)
print(name_list)

# 3- remove() 移除列表中某个指定数据  如果不存在, 也不会报错 无效果
name_list.remove("小诺")
print(name_list)

# 修改操作
# 1-  修改某个索引的值
name_list[0] = '大明'
print(name_list)

# 2- reverse: 反转操作
name_list.reverse()

print(name_list)

# 3- 排序操作: reverse 设置 是否反转   True 反转(倒序)  False 不反转(正序)
num_list = [3, 7, 10, 56, 2, 9, 4, 5]
num_list.sort(reverse=True)
print(num_list)
列表的循环遍历
循环遍历就是使用while或for循环对列表中的每个数据进行打印输出

while循环:
star_list = ['西施', '王昭君', '杨玉环']
i = 0
while i < len(star_list):
    print(star_list[i])
    i += 1
for循环(个人比较推荐):
star_list = ['西施', '王昭君', '杨玉环']
for star in star_list:
    print(star)
列表的嵌套
列表的嵌套:列表中又有一个列表,我们把这种情况就称之为列表嵌套
在其他编程语言中,称之为叫做二维数组或多维数组

应用场景:要存储班级一、二、三 => 三个班级学生姓名,且每个班级的学生姓名在一个列表。
classes = ['第一个班级','第二个班级','第三个班级']

一班:['小明', '小红']
二班:['小刚', '小丽']
三班:['小强', '小芳']

把班级和学员信息合并在一起,组成一个嵌套列表
students = [['小明', '小红'],['小刚', '小丽'],['小强', '小芳']]

students = [x,y,z]
students[0] == ['小明', '小红']
students[0][1]
问题:嵌套后的列表,我们应该如何访问呢?
# 访问小红
print(students[0][1])
# 嵌套列表进行遍历,获取每个班级的学员信息
for i in students:
    print(i)
相关演示:
# 演示 列表嵌套
# 说明: 容器内部嵌套容器方式
# 需求: 有 三个班级, 分别为 前端1班 前端2班  后端1班, 每个班级分别有5位学生
# 定义 班级列表
front1_class = ['小明','小红','小刚','小丽','小强']
front2_class = ['小芳','小亮','小宇','小浩','小琪']
back1_class = ['小诺','小泽','小琳','小航','小彤']

# 定义 学校列表, 学校列表中有三个班级
school_list = [front1_class,front2_class,back1_class]

# 以上内容 如果直接使用列表嵌套写法
school_list = [
    ['小明','小红','小刚','小丽','小强'],
    ['小芳','小亮','小宇','小浩','小琪'],
    ['小诺','小泽','小琳','小航','小彤']
]

# 如何 获取里面的数据呢?  比如 我想获取到 小浩
front2_class = school_list[1]
name = front2_class[3]
print(name)

# 可以简写
name = school_list[1][3]
print(name)

# 如何遍历打印每一个元素
for classes in school_list:
    for name in classes:
        print(name)
    print("-----------")
列表案例
:::color4
案例需求:
判断相邻元素的变化趋势
给定一个正整数数组,判断每一对相邻元素是"上升"“下降"还是"相等”,并输出结果列表
例如: 输入: [3, 5, 5, 2, 4] 输出: ['上升', '相等', '下降', '上升']
:::
实现思路① 定义原始列表
② 创建一个空列表用于保存结果
③ 遍历相邻元素(当前值和下一个值)
④ 比较大小关系
- 当前 < 下一个 → 上升
- 当前 > 下一个 → 下降
- 相等 → 相等
⑤ 将结果添加到列表中
⑥ 输出结果
# 判断相邻元素变化趋势

num_list = [3, 5, 5, 2, 4]

result_list = []

i = 0

while i < len(num_list) - 1:
    if num_list[i] < num_list[i + 1]:
        result_list.append("上升")
    elif num_list[i] > num_list[i + 1]:
        result_list.append("下降")
    else:
        result_list.append("相等")

    i += 1

print(result_list)
巩固练习
:::color4
找出列表中第一次出现的重复元素
给定一个列表,找到第一个重复出现的元素(只要出现第二次就算重复),并输出该元素
例如: 输入: [2, 3, 5, 3, 6, 5, 7] 输出: 3
:::
实现思路
① 创建一个空列表用于记录已经出现过的元素
② 遍历原始列表
③ 判断当前元素是否已经出现过
- 如果出现过 → 直接输出并结束
- 如果没有 → 添加到记录列表
④ 如果循环结束都没找到,说明没有重复
```python # 找第一个重复元素num_list = [2, 3, 5, 3, 6, 5, 7]
seen_list = []
for e in num_list:
if e in seen_list:
print(e)
break
else:
seen_list.append(e)
## 元组的定义与使用
### 为什么需要元组
<details class="lake-collapse"><summary id="ue2571ad0"><strong><span class="ne-text" style="color: rgb(255, 111, 4); background-clip: text; -webkit-background-clip: text; -webkit-text-fill-color: transparent; background-image: linear-gradient(90deg, rgb(255, 111, 4) 0%, rgb(243, 48, 171) 100%);">思考:如果想要存储多个数据,但是这些数据是不能修改的数据,怎么做?</span></strong></summary><p id="u71ee2cf6" class="ne-p"><span class="ne-text">答:列表?列表可以一次性存储多个数据,但是列表中的数据允许更改。</span></p></details>
<details class="lake-collapse"><summary id="u725f44c0"><strong><span class="ne-text" style="color: rgb(255, 111, 4); background-clip: text; -webkit-background-clip: text; -webkit-text-fill-color: transparent; background-image: linear-gradient(90deg, rgb(255, 111, 4) 0%, rgb(243, 48, 171) 100%);">那这种情况下,我们想要存储多个数据且数据不允许更改,应该怎么办呢?</span></strong></summary><p id="u4da1de74" class="ne-p"><span class="ne-text">答:使用元组,元组可以存储多个数据且元组内的数据是不能修改的。</span></p></details>

### 元组的定义
元组特点:**<font style="color:#74B602;">定义元组使用小括号,且使用逗号隔开各个数据,数据可以是不同的数据类型</font>**。
基本语法:
```python
# 多个数据元组
tuple1 = (20, 30, 40)
# 单个数据元组
tuple2 = (20,)
注意:如果定义的元组只有一个数据,那么这个数据后面也要添加逗号,否则数据类型为唯一的这个数据的数据类型。
元组的相关操作方法
由于元组中的数据不允许直接修改,所以其操作方法大部分为查询方法。
| 函数 | 作用 |
|---|---|
| 元组[索引] | 根据索引下标查找元素 |
| index() | 查找某个数据,如果数据存在返回对应的下标,否则报错,语法和列表、字符串的index方法相同 |
| count() | 统计某个数据在当前元组出现的次数 |
| len() | 统计元组中数据的个数 |
# 1- 如何定义元组
# 格式:
#   变量名称 = (元素1,元素2,元素3......)
#   变量名称 = (元素1,) : 如果元组中只有一个元素, 必须在后面添加一个逗号 否则编译器会自动转换为 数据的本身类型, 而不是元组类型
user_tuple = ('小明','小红','小刚',20,30,40,True,False)
print(user_tuple)
print(type(user_tuple))

tuple1 = ('小明',)
print(tuple1)
print(type(tuple1))

# 2- 如何使用元组
# 2.1 获取元组中某个元素:  与 列表 和 字符串 一致 都是通过索引的方式来获取
print(user_tuple[0])
print(user_tuple[1])
print(user_tuple[2])

# 2.2 遍历: 与 列表 一致
for e in user_tuple:
    print(e)

# 2.3 获取某个元素在元组中索引值: index
print(user_tuple.index(True))

# 2.4 获取某个元素在元组中出现了几次
print(user_tuple.count('小刚'))

# 2.5 获取元组长度
print(len(user_tuple))
元组案例
:::color4
案例需求1
编写一个程序,计算嵌套元组中所有数字的总和。
例如:在嵌套元组 ((2,3,4),(3,5,7),(3,4,6)) 中,所有元素相加的结果为:
2+3+4+3+5+7+3+4+6 = 37
输出结果为:37
:::
实现思路① 定义一个嵌套元组
② 定义一个变量,用来保存总和,初始值为 0
③ 使用外层循环遍历每个子元组
④ 使用内层循环遍历子元组中的每个元素
⑤ 将每个元素依次累加到总和变量中
⑥ 输出最终结果

1- 初始化嵌套元组
tuple1 = (
(2, 3, 4),
(3, 5, 7),
(3, 4, 6)
)
2- 定义变量,用于保存总和
total = 0
3- 遍历嵌套元组中的每个子元组
for tup_e in tuple1:
# 4- 遍历子元组中的每个元素
for e in tup_e:
# 5- 累加每个元素
total += e
6- 打印结果
print(total)
:::color4
**案例需求2**

给定一个元组 `my_tuple`,里面包含 `2, 3, 4, 5, 6, 7, 8, 9, 10` 元素,要求找出其中所有大于 5 的数字,并放入一个新列表中。

输出结果为:`[6, 7, 8, 9, 10]`

:::

<details class="lake-collapse"><summary id="u30d2b1db"><strong><span class="ne-text">实现思路</span></strong></summary><p id="u42830a81" class="ne-p"><span class="ne-text">① 定义一个元组</span></p><p id="ue9df396c" class="ne-p"><span class="ne-text">② 创建一个空列表,用于保存大于 5 的数字</span></p><p id="u605b8c62" class="ne-p"><span class="ne-text">③ 遍历元组中的每个元素</span></p><p id="ub207ca4c" class="ne-p"><span class="ne-text">④ 判断当前元素是否大于 5</span></p><p id="u61a5016f" class="ne-p"><span class="ne-text">⑤ 如果大于 5,就添加到结果列表中</span></p><p id="u14c195cc" class="ne-p"><span class="ne-text">⑥ 输出结果列表</span></p></details>
```python
# 给定一个元组my_tuple,找出其中所有大于5的数字

my_tuple = (2, 3, 4, 5, 6, 7, 8, 9, 10)

# 1- 创建空列表,用于保存结果
result_list = []

# 2- 遍历元组中的每个元素
for e in my_tuple:
    # 3- 判断是否大于5
    if e > 5:
        # 4- 如果大于5,则添加到列表中
        result_list.append(e)

# 5- 打印结果
print(result_list)
集合的定义与使用
什么是集合
集合(set)是一个**无序的不重复元素序列**。

① 天生去重
② 无序
集合的定义
在Python中,我们可以使用一对花括号{}或者set()方法来定义集合,但是如果你定义的集合是一个空集合,则只能使用set()方法。
# 1- 如何定义集合
# 格式:
#       格式一:  变量名称 = {元素1,元素2,元素3......}
#       格式二:  变量名称 = set()   空集合
# 特性: 无序 + 去重
# 定义一个有内容的集合
name_set = {'小明','小红','小刚','小明','小刚','小丽'}

print(name_set) #  去重 和 无序  发现每次都是不一样的 所以是无序的
print(type(name_set))
# 定义 空集合
# set2 = {}  # 此种定义方法 并不是定义空集合, 而是空的字典
empty_set = set()
print(type(empty_set))

# 获取数据: 遍历的方式
# for 循环
for name in name_set:
    print(name)
集合操作的相关方法(增删查)
☆ 集合的增操作
add()方法:向集合中增加一个元素(单一)
name_set = {'小明','小红','小刚'}
name_set.add('小强')
print(name_set)
☆ 集合的删操作
remove()方法:删除集合中的指定数据,如果数据不存在则报错。
name_set = {'小明','小红','小刚'}
name_set.remove('小红')
print(name_set)
☆ 集合中的查操作
① in :判断某个元素是否在集合中,如果在,则返回True,否则返回False
② not in :判断某个元素不在集合中,如果不在,则返回True,否则返回False
name_set = {'小明','小红','小刚'}
print('小明' in name_set)  # True
print('小丽' not in name_set)  # True
③ 集合的遍历操作
name_set = {'小明','小红','小刚'}
for name in name_set:
    print(name)
相关操作
# 演示 集合的API
num_set = {3,4, True,'小明',False}
# 1- 添加数据的API: add
num_set.add("小红")
print(num_set)

# 2- 删除数据的API: remove  在删除的时候 如果在集合中没有该值 会直接报错
num_set.remove(False)

print(num_set)

# 3- 判断是否存在和不存在操作: in 和 not in
# 如果 小刚在集合中不存在, 请添加该元素
if '小刚' not in num_set:
    # 能进来, 说明 小刚 不在集合中
    num_set.add('小刚')

print(num_set)
集合案例
"""
💡 题目:给定一个连续递增的整数列表,找出中断的位置。
例如:[1, 2, 3, 5, 6, 8] 中,3→5 断了,6→8 也断了。
"""
'''
定义集合方式
方式1 空集合: empty_set = set()
方式2 包含元素的集合 my_set = {元素1, 元素}
'''

# 定义空集合
empty_set = set()
# 打印集合
print(empty_set)
print(type(empty_set))

# 定义空字典
empty_dict = {}
print(empty_dict)
print(type(empty_dict))

# 定义一个包含元素的集合
name_set = {'小明','小红','小刚','小明','小刚','小刚'}
print(name_set)
print(type(name_set))

# 遍历
for name in name_set:
    print(name)

# 增加元素
name_set = {'小明','小红','小刚'}
name_set.add('小强')
print(name_set)

# 删除元素
name_set.remove('小强')
print(name_set)

# 判断元素是否在集合中, in和not in
if '小明' in name_set:
    print('小明在集合中')
else:
    print('小明不在集合中')

# 判断元素不在集合中
if '小强' not in name_set:
    print('小强不在集合中')
else:
    print('小强在集合中')

"""
💡 题目:一个数组中除了两个数字只出现一次外,其他数字都出现两次。
       找出这两个只出现一次的数字。
输入: [4, 1, 2, 1, 2, 3, 5, 5]
输出: 3 和 4

思路:
1. 准备集合A和列表B,集合A用来存储出现的数字,集合B用来记录只出现过1次的数字
2. 将出现的数字和集合A判断,如果集合A中有数字,说明这个数字出现过,将数字从集合B
中删除。
如果A中没有这个数字,说明数字没出现过,将数字放入集合A和集合B
3. 最后循环结束,打印集合B,就是只出现一次的数字了
"""
num_list = [4, 1, 2, 1, 2, 3, 5, 5]
# 存储所有出现的数字
set_a = set()
# 存储只出现一次的数据
set_b = set()
for num in num_list:
    # num没有出现过
    if num not in set_a:
        set_a.add(num)
        set_b.add(num)
        continue
    # num出现过,则从set_b中移除该数字
    set_b.remove(num)

print('出现过1次的数字: ')
for num in set_b:
    print(num,end='\t')
print()
"""
💡 题目:统计列表中每个数字出现的次数,并按数字大小排序输出。
输入: [4, 2, 2, 8, 3, 3, 1, 4, 3]
"""
"""
💡 题目:判断一个列表中的数字是否能组成连续序列。
例如:[4, 2, 3, 1] → True(可以重排成 [1,2,3,4])
      [5, 3, 2, 6] → False(范围是 2~6,缺了 4)
"""
"""
💡 题目:给你一个 1 到 n 的数组,但缺少了一些数字。
       找出所有 1~n 范围内消失的数字。
输入: [4, 3, 2, 7, 8, 2, 3, 1]  (n=8,但数组里缺了 5, 6)
"""
字典的定义与使用
为什么需要字典(dict)
思考1:比如我们要存储一个人的信息,姓名:ZhangSan,年龄:19周岁,性别:男,家庭住址:上海市浦东新区,如何快速存储。person = ['ZhangSan', 19, '男', '上海市浦东新区']
答:使用Python中的字典
Python中字典(dict)的概念

:::info
特点:
① 符号为大括号(花括号) => {}
② 数据为键值对形式出现 => {key:value},key:键名,value:值,在同一个字典中,key必须是唯一(类似于索引下标)
③ 各个键值对之间用逗号隔开
:::
在字典中,键名除了可以使用字符串的形式,还可以使用数值的形式来进行表示
# 有数据字典
dict1 = {'name': 'ZhangSan', 'age': 19, 'gender': '男'}

# 空字典
dict2 = {}

dict3 = dict()
# 1- 演示: 如何定义字典
# 格式:
#   格式1:  变量名称 = {key1:value1,key2:value2,key3:value3.....}
#   格式2:  变量名称 = {}  或者 变量名称 = dict()   空字典

# 构建一个有内容的字典
person = {'name': '小明', 'age': 19, 'address': "上海市浦东新区张江镇", 'sex': '男', 'hobby': '篮球、足球、游泳'}
print(person)
print(type(person))

# 构建空字典
dict1 = {}
dict2 = dict()
print(dict1)
print(type(dict1))
print(dict2)
print(type(dict2))

# 遍历操作
for key in person:
    print(key)
    print(person[key])
字典的增操作
字典名称[key] = value
注:如果key存在则修改这个key对应的值;如果key不存在则新增此键值对。
字典的删操作
① del 字典名称[key]:删除指定元素
person = {'name': '小明', 'age': 19}
del person['age']
print(person)
② clear()方法:清空字典中的所有key
person = {'name': '小明', 'age': 19}
person.clear()
print(person)
字典的改操作
基本语法:
字典名称[key] = value
注:如果key存在则修改这个key对应的值;如果key不存在则新增此键值对。
案例:定义一个字典,里面有name、age以及address,修改address这个key的value值
person = {'name': '小明', 'age': 19, 'address': '上海市浦东新区'}
person['address'] = '上海市黄浦区'
print(person)
字典的查操作

① 查询方法:使用具体的某个key查询数据,如果未找到,则直接报错。
字典序列[key]
② 字典的相关查询方法
| 函数 | 作用 |
|---|---|
| keys() | 以列表返回一个字典所有的键 |
| values() | 以列表返回字典中的所有值 |
| items() | 以列表返回可遍历的(键, 值) 元组数据 |
案例1:提取person字典中的所有key
person = {'name': '小明', 'age': 19, 'address': '上海市浦东新区'}
print(person.keys())
案例2:提取person字典中的所有value值
person = {'name': '小明', 'age': 19, 'address': '上海市浦东新区'}
print(person.values())
案例3:使用items()方法提取数据
person = {'name': '小明', 'age': 19, 'address': '上海市浦东新区'}
print(person.items())
相关的API操作:
# 字典的相关API:
# 如何增加元素:
# 需求: 为person 字典增加一个 birthday 属性 值为 2005-08-20
person = {'name': '小明', 'age': 19, 'address': "上海市浦东新区张江镇", 'sex': '男', 'hobby': '篮球、足球、游泳'}
person["birthday"] = '2005-08-20'

print(person)

# 如何修改元素: 与添加一直, 如果key存在就是修改 如果不存在 就是添加
# 需求: 修改性别为 女
person['sex'] = "女"
print(person)

# 如何删除元素
# 删除某个元素:  根据key
del person['birthday']
print(person)
# 清空字典
# person.clear()
# print(person)

# 如何查询:
# 1- 根据 key 直接获取value: 如果key 不存在 直接报错
# 获取 address的值
print(person['address'])

# 2- 获取所有的keys
keys_list = person.keys()
print(keys_list)
# 3- 获取所有的value
values_list = person.values()
print(values_list)
# 4- 获取字典中每一个 kv对
# 快速返回变量: ctrl + alt + v
items = person.items()
print(items)

for kv in items:
    print(kv)
    print(f'{kv[0]},{kv[1]}')
字典案例
:::color4
案例需求
给定一个字符串my_string,现在要求统计每个字符出现的次数: 形成结果: {‘字符’:出现次数,‘字符2’:次数}例如: ‘abcdecf’ ==> {‘a’:1,‘b’:1,‘c’:2,‘d’:1,‘e’:1,‘f’:1}
:::
实现思路
①定义一个字符串
②初始化空字典,来存储对应字符和出现次数
③循环遍历字符串中每个字符
④如果字符串已经在字典中,计数加1,如果不在,初始化计数1: 字典['key'] += 1
⑤输出统计每个字符出现的次数
```python """ 给定一个字符串my_string,现在要求统计每个字符出现的次数: 形成结果: {'字符':出现次数,'字符2':次数}例如: 'abcdecf' ==> {'a':1,'b':1,'c':2,'d':1,'e':1,'f':1}
“”"
1- 创建一个字符串
my_string = ‘abcdecf’
2- 遍历字符串, 获取每一个字符
2.1 初始化一个用于保存结果的空字典
my_dict = {}
for e in my_string:
# 2.2 判断 当前遍历的这个元素 是否在 字典中存在呢?
if e in my_dict.keys():
    # 说明 当前遍历的元素 在 字典中是存在的
    my_dict[e] += 1
else:
    # 说明 当前遍历的元素 在 字典中是不存在的
    my_dict[e] = 1
print(my_dict)
## 四种数据结构对比总结

| 数据结构 | 可变性 | 有序性 | 是否去重 | 定义符号 | 适用场景 |
| :--- | :--- | :--- | :--- | :--- | :--- |
| 列表 (list) | 可变 | 有序 | 不去重 | `[]` | 存储有序集合,需要增删改 |
| 元组 (tuple) | 不可变 | 有序 | 不去重 | `()` | 存储不应被修改的常量数据 |
| 集合 (set) | 可变 | 无序 | 去重 | `{}` 或 `set()` | 去重、成员判断、集合运算 |
| 字典 (dict) | 可变 | 有序(Python 3.7+) | 键去重 | `{k:v}` 或 `dict()` | 键值对映射、计数、配置 |
# 函数详解
## 容器拆包与推导式

### 容器拆包
#### 什么是拆包?
**<font style="color:#74B602;">简单来说就是把一个元组中的数据一个一个拆解出来的过程,就称之为叫做拆包操作。</font>**

#### 基本语法
```python
tuple1 = (10, 20)
# 拆包
num1, num2 = tuple1
以上代码可以简写为
num1, num2 = (10, 20)
还可以进一步简写
num1, num2 = 10, 20
拆包典型案例
定义一个容器(元组)
tuple1 = ("炸鸡", True, 25.5)
将元组中每个元素分别赋值给三个变量
name, is_flag, price = tuple1

print(f"{name},{is_flag},{price}")
输出:炸鸡,True,25.5
其他自动拆包方式
a, b = (10, 20)
print(f"{a},{b}")

a, b = 10, 20
print(f"{a},{b}")
两变量值交换

初始化两个变量
c1 = '游戏手柄'
c2 = 'Switch'
直接交换(利用自动拆包)
c1 = '游戏手柄'
c2 = 'Switch'

c2, c1 = c1, c2

print(c1)
print(c2)
输出:
Switch
游戏手柄
使用临时变量(不用自动拆包)
c1 = '游戏手柄'
c2 = 'Switch'

tmp = c1
c1 = c2
c2 = tmp

print(c1)
print(c2)
输出:
Switch
游戏手柄

总结:自动拆包本质上就是把容器的每个元素"打散"分别赋值给对应位置的变量,变量数量必须和元素数量一致。变量交换时直接 <font style="color:#74B602;">a, b = b, a</font> 即可,比传统临时变量法简洁得多
推导式
什么是推导式
推导式comprehensions(又称解析式),是Python的一种独有特性。推导式是可以从一个数据序列构建另一个新的数据序列(一个有规律的列表或控制一个有规律列表)的结构体。 共有三种推导:列表推导式、集合推导式、字典推导式。

为什么需要推导式
案例:创建一个0-9的列表
while循环:
# 初始化计数器
i = 0
list1 = []
# 编写循环条件
while i <= 9:
    list1.append(i)
    # 更新计数器
    i += 1
print(list1)
for循环:
list1 = []
# 编写for循环
for i in range(0, 10):
    list1.append(i)
print(list1)

列表推导式
基本语法:
变量名 = [表达式 for 变量 in 列表]
变量名 = [表达式 for 变量 in 列表 if 条件]
变量名 = [表达式 for 变量 in 列表 for 变量 in 列表]

案例:定义0-9之间的列表
list1 = []
for i in range(10):
    list1.append(i)
print(list1)
列表推导式
# 推导式演示:
"""
    格式:
        变量名 = [表达式 for 变量 in 列表]
        变量名 = [表达式 for 变量 in 列表 if 条件]
        变量名 = [表达式 for 变量 in 列表 for 变量 in 列表]

"""

# 案例1:定义0-9之间的列表
# 非推导式方式
my_list = []

for i in range(0, 10):
    my_list.append(i)

print(my_list)

# 推导式:
my_list = [i for i in range(0, 10)]
print(my_list)

# 案例2: 给定一个列表, 将该列表内容依次添加到另一个集合中, 实现去重效果 得到一个集合:  {7,9,5,4,6}
my_list2 = [7, 9, 5, 4, 5, 7, 6]

# 非推导方式:
my_set1 = set()

for e in my_list2:
    my_set1.add(e)

print(my_set1)

# 推导式方式:
my_set2 = {e for e in my_list2}
print(my_set2)
执行原理:[i for i in range(10)]
列表推导式先运行表达式右边的内容:

当第一次遍历时:i = 0,其得到变量i的结果后,会放入最左侧的变量i中,这个时候列表中就是[0]
当第二次遍历时:i = 1,其得到变量i的结果后,会追加最左侧的变量i中,这个时候列表中就是[0, 1]
...
当最后一次遍历时:i = 9,其得到变量i的结果后,会追加最左侧的变量i中,这个时候列表中就是[0, 1, 2, 3, 4, 5, 6, 7, 8, 9]

列表推导式 + if条件判断
在使用列表推导式时候,我们除了可以使用for循环,其实我们还可以在其遍历的过程中,引入if条件判断。
变量 = [表达式 for 临时变量 in 序列 if 条件判断]

等价于

for 临时变量 in 序列:
    if 条件判断

案例:生成0-9之间的偶数(i%2 0)序列
#  推导式 含  IF 操作
# 格式: 变量 = [表达式 for 临时变量 in 序列 if 条件判断]

# 需求: 案例:生成0-9之间的偶数(i%2  0)序列
# 非推导式方式
my_list3 = []
for e in range(0, 10):
    if e % 2 == 0:
        my_list3.append(e)


print(my_list3)

# 推导式:
my_list4 = [e for e in range(0, 10) if e % 2 == 0]

print(my_list4)

# 需求2: 生成 0~9的序列, 然后将 > 5的数据 存储到一个新的列表中
# 推导式
my_list5 = [ e for e in range(0,10) if e > 5 ]
print(my_list5)
for循环嵌套列表推导式
for 临时变量 in range(n):
    for 临时变量 in range(n):
基本语法:
变量 = [表达式 for 临时变量 in 序列 for 临时变量 in 序列]

🪑** 座位表生成案例**
需求:生成教室座位坐标列表
假设一个 3行 × 4列 的教室,生成所有座位的坐标:
座位布局:
第0列  第1列  第2列  第3列
行0: (0,0)  (0,1)  (0,2)  (0,3)
行1: (1,0)  (1,1)  (1,2)  (1,3)
行2: (2,0)  (2,1)  (2,2)  (2,3)
方法一:for循环嵌套
seats = []

# 外层循环:遍历每一行
for row in range(3):
    # 内层循环:遍历每一列
    for col in range(4):
        seat = (row, col)
        seats.append(seat)

print(seats)
输出:
[(0, 0), (0, 1), (0, 2), (0, 3),
 (1, 0), (1, 1), (1, 2), (1, 3),
 (2, 0), (2, 1), (2, 2), (2, 3)]
方法二:列表推导式
# 推导式方式(更简洁)
seats = [(row, col) for row in range(3) for col in range(4)]

print(seats)
输出:
[(0, 0), (0, 1), (0, 2), (0, 3),
 (1, 0), (1, 1), (1, 2), (1, 3),
 (2, 0), (2, 1), (2, 2), (2, 3)]
对比记忆
| 对比项 | for循环嵌套 | 列表推导式 |
|---|---|---|
| 代码行数 | 多行 | 一行搞定 |
| 可读性 | 逻辑清晰 | 简洁但稍难读 |
| 执行效率 | 稍慢 | 更快 |
| 适用场景 | 复杂逻辑 | 简单转换 |
推导式本质就是:
# 外层 for 在前,内层 for 在后
[表达式 for 外层变量 in 外层范围 for 内层变量 in 内层范围]
更多练习 🎯
题目1: 生成 2×3 的棋盘坐标(从 (1,1) 开始)
# 推导式
chess = [(i, j) for i in range(1, 3) for j in range(1, 4)]
# 结果: [(1,1),(1,2),(1,3),(2,1),(2,2),(2,3)]
题目2: 生成所有 (0-9, 0-9) 的坐标对(排除对角线 i==j)
# 推导式
coords = [(i, j) for i in range(10) for j in range(10) if i != j]
推导式案例
案例一:使用列表推导式生成平方数集合
例如, 用户输入10, 表示要生成 1~10的每一个数字的平方的集合
# 推导式案例: 案例一:使用列表推导式生成平方数集合
# 例如, 用户输入10, 表示要生成 1~10的每一个数字的2平方的集合
# 1- 让用户输入一个正整数
n = int(input("请输入一个正整数:"))

# 2- 遍历 从 1 ~ N
# 2.1 初始化一个空列表
my_list7 = []
for j in range(1,n+1):
    # 2.2 计算 2的平方 将结果写入列表
    my_list7.append(j ** 2)

print(my_list7)

# 推导式 如何解决
my_list8 = [ j ** 2 for j in range(1,n+1)]
print(my_list8)

函数

Python中函数的作用与使用步骤

函数的定义
基本语法:
def 函数名称(参数1, 参数2, ...):
    函数体
    ...
    [return 返回值]


注意: 语法中的中括号表示的可选的意思
在Python中,函数和变量一样,都是先定义后使用。
# 定义函数
def 函数名称([参数1, 参数2, ...]):
    函数体
    ...
    [return 返回值]

# 调用函数
函数名称(参数1, 参数2, ...)
背包物品管理

1️⃣ 第一步:不用函数 — 重复代码写到手酸
# 场景:游戏角色背包里有 100 个空格
# 每次捡到道具,都要用掉一个空格

# 第一次捡到药水
inventory = 100
inventory -= 1
print(f"捡到1个道具,背包还剩 {inventory} 个空格")

# 第二次捡到武器
inventory -= 1
print(f"捡到1个道具,背包还剩 {inventory} 个空格")

# 第三次捡到宝石
inventory -= 1
print(f"捡到1个道具,背包还剩 {inventory} 个空格")

# 第四次捡到装备
inventory -= 1
print(f"捡到1个道具,背包还剩 {inventory} 个空格")
问题: 每次捡道具都要写一模一样的 3 行代码,太繁琐了!💀
2️⃣ 第二步:封装成函数 — 代码复用
# 定义一个函数:捡道具
def pick_item():
    """捡起一个道具,自动占用背包一个空格"""
    print("捡到1个道具!")

# 调用函数,不用重复写代码了
pick_item()      # 第1次捡道具
pick_item()      # 第2次捡道具
pick_item()      # 第3次捡道具
pick_item()      # 第4次捡道具
输出:
捡到1个道具!
捡到1个道具!
捡到1个道具!
捡到1个道具!
好处: 🎉 定义一次,随时调用!再也不用复制粘贴了!
3️⃣ 第三步:函数带参数 — 告诉函数具体捡什么
# 场景:捡到的东西不一样,打印的信息也要不一样
# 用参数来解决这个问题

def pick_item(item_name):
    """捡起一个道具

    参数:
        item_name: 道具名称
    """
    print(f"捡到了 【{item_name}】!")

# 调用时传入具体道具名
pick_item("生命药水")   # 捡到生命药水
pick_item("火焰剑")     # 捡到火焰剑
pick_item("蓝宝石")     # 捡到蓝宝石
pick_item("黄金头盔")   # 捡到黄金头盔
输出:
捡到了 【生命药水】!
捡到了 【火焰剑】!
捡到了 【蓝宝石】!
捡到了 【黄金头盔】!
好处: 🎯 一个函数,变出无数种用法!
4️⃣ 第四步:函数带返回值 — 告诉调用者结果
# 场景:希望函数告诉调用者,捡道具到底成不成功
# 比如背包满了就捡不了

# 设定背包容量
bag_capacity = 100
current_count = 0

def pick_item(item_name):
    """捡起一个道具
    返回 True 表示成功,False 表示失败(背包满了)
    """
    global current_count  # 声明使用全局变量

    # 检查背包是否满了
    if current_count >= bag_capacity:
        return False  # 捡不了,返回失败

    current_count += 1
    print(f"捡到了 【{item_name}】!背包进度:{current_count}/{bag_capacity}")
    return True  # 捡到了,返回成功

# 调用并判断结果
result = pick_item("生命药水")
if result:
    print("✅ 捡道具成功!")
else:
    print("❌ 背包已满,无法捡取!")

result = pick_item("火焰剑")
if result:
    print("✅ 捡道具成功!")
else:
    print("❌ 背包已满,无法捡取!")
输出:
捡到了 【生命药水】!背包进度:1/100
✅ 捡道具成功!
捡到了 【火焰剑】!背包进度:2/100
✅ 捡道具成功!

📊 总结对比
| 阶段 | 代码特点 | 能做什么 |
|---|---|---|
| 无函数 | 重复代码多 | 基本功能 |
| 无参函数 | 定义一次,调用多次 | 代码复用 |
| 带参函数 | 传入不同数据 | 一函多用 |
| 带返回值函数 | 返回执行结果 | 反馈给调用者 |
return返回值

思考1:如果一个函数如些两个return (如下所示),程序如何执行?
def return_num():
    return 1
    return 2


result = return_num()
print(result)  # 1
答:只执行了第一个return,原因是因为return可以退出当前函数,导致return下方的代码不执行。
思考2:如果一个函数要有多个返回值,该如何书写代码?
答:在Python中,理论上一个函数只能返回一个结果。但是如果我们向让一个函数可以同时返回多个结果,我们可以使用return 元组的形式。
def return_num():
    return 1, 2


result = return_num()
print(result)
print(type(result))  # <class 'tuple'>
思考3:封装一个函数,参数有两个num1,num2,求两个数的四则运算结果
四则运算:加、减、乘、除
def size(num1, num2):
    jia = num1 + num2
    jian = num1 - num2
    cheng = num1 * num2
    chu = num1 / num2
    return jia, jian, cheng, chu


# 调用size方法
print(size(20, 5))
相关演示:
# 需求: 请帮我定义一个函数: computer 计算器函数, 要求给这个函数传入 2个参数, 在函数的内部完成  + - 计算, 并且将 + -的二个结果返回

# 定义函数:
def computer(a, b):
    # 编写函数功能的核心位置
    jia = a + b
    jian = a - b

    # 将加和减结果一并返回
    return jia, jian
    # return [jia, jian]
    # return {jia, jian}
    # return {'jia':jia,'jian':jian}


# 调用函数
# res = computer(3,5)
i,j = computer(3,5)  # 利用自动拆包思想

print(f'加法结果:{i},减法的结果:{j}')
函数的嵌套及案例
什么是函数的嵌套
所谓函数嵌套调用指的是一个函数里面又调用了另外一个函数。

函数嵌套的基本语法
def funca():
    return 2
def funcb():
    return funca()

funcb()
扩展递归

# 1 利用递归实现阶乘运算
'''
递归: 一个函数自己调用自己,就是递归
必要条件: 要有结束条件
'''
def func_c(num:int):
    '''
    通过递归实现求阶乘操作
    :param num:参数
    :return: int
    '''
    if num <= 1:
        return 1
    return num * func_c(num-1)


print(func_c(3))
# 2 利用递归青蛙台阶
'''
分治思想,分而治之,简称分治
将一个大问题,拆解为相似的小问题,逐个击破
'''

'''
需求:有一个小青蛙,每次可以跳1个台阶,或者跳2个台阶,总共10个台阶,问有多少种走法
思路:
1. 当仅有一个台阶,那么就是1中走法,fn(1) = 1
2. 当有两个台阶,那么有两种走法,f(2) = 2
3. 当有三个台阶, 那么有这些走法 f(3) = f(2) + f(1)
4. 如果有四级台阶, 那么走法为f(4) = f(3) + f(2)
5. 如果有n级台阶,那么走法为f(n) = f(n-1) + f(n-2)
'''
def fn_steps(n):
    if n == 1:
        return 1
    if n == 2:
        return 2
    return fn_steps(n-1) + fn_steps(n-2)

print(fn_steps(10))


# 3 实现汉诺塔
'''
汉诺塔
移动n个盘子,从A--->C盘
思路:
将前n-1个盘子从A柱借助C柱移动到B柱
将第n个盘子从A柱移动到C柱
将前n-1个盘子从B柱借助A柱移动到C柱
'''

def hanuota(num, A,B,C):
    '''
    这是一个汉诺塔函数,表示将num个盘子,从A柱移动到C柱的流程
    :param num: 盘子个数
    :param A:  A柱子,起始柱子
    :param B:  B柱子,辅助柱子
    :param C:  C柱子,目的柱子
    :return: None
    '''
    if num == 1:
        print(f'将第{num}个盘子从{A}移动到{C}')
        return
    # 将num-1个盘子从A借助C移动到B
    hanuota(num-1, A,C,B)
    # 将第num个盘子,从A移动到C
    print(f'将第{num}个盘子从{A}移动到{C}')
    # 将num-1个盘子从B借助A移动到C
    hanuota(num-1,B,A,C)

hanuota(3,'A','B','C')

变量的作用域
什么是变量的作用域
变量作用域指的是变量的作用范围(变量在哪里可用,在哪里不可用),主要分为两类:全局作用域与局部作用域。
其实作用域的划分比较简单,在函数内部定义范围就称之为局部作用域,在函数外部(全局)定义范围就是全局作用域

# 全局作用域
def func():
    # 局部作用域
局部变量与全局变量
在Python中,定义在函数外部的变量就称之为全局变量;定义在函数内部变量就称之为局部变量。
# 定义在函数外部的变量(全局变量)
num = 10
# 定义一个函数
def func():
    # 函数体代码
    # 定义在函数内部的变量(局部变量)
    num = 100
演示全局和局部的使用场景
# 演示: 全局和局部变量:
#  全局变量: 指的是定义在函数外部的变量称为全局变量
#  局部变量: 指的是定义在函数内部的变量称为局部变量
#  全局变量的作用范围: 是整个全局的范围内, 一旦定义后, 在当前这个文件的任意位置均可以使用该变量
#  局部变量的作用范围: 仅在当前这个函数的内部, 一旦出了这个函数, 该变量就相当于不存在

# 定义一个全局变量:
a = 100

# 定义一个函数
def fun1():
    # 定义一个局部变量:
    b = 200
    # 在函数内部使用全局变量
    print(f"函数内--输出a的值为:{a}")
    print(f"函数内--输出b的值为:{b}")


# 调用函数
fun1()

# 在函数外部使用全局变量
print(f"函数外输出a的值:{a}")
# print(f"函数外输出a的值:{b}")
变量作用域的作用范围
全局变量:在整个程序范围内都可以直接使用
str1 = 'hello'
# 定义一个函数
def func():
    # 在函数内部调用全局变量str1
    print(f'在局部作用域中调用str1变量:{str1}')

# 直接调用全局变量str1
print(f'在全局作用域中调用str1变量:{str1}')
# 调用func函数
func()
局部变量:在函数的调用过程中,开始定义,函数运行过程中生效,函数执行完毕后,销毁
# 定义一个函数
def func():
    # 在函数内部定义一个局部变量
    num = 10
    print(f'在局部作用域中调用num局部变量:{num}')

# 调用func函数
func()
# 在全局作用域中调用num局部变量
print(f'在全局作用域中调用num局部变量:{num}')
global关键字的应用场景

思考一个问题:我们能不能在局部作用域中对全局变量进行修改呢?
'''
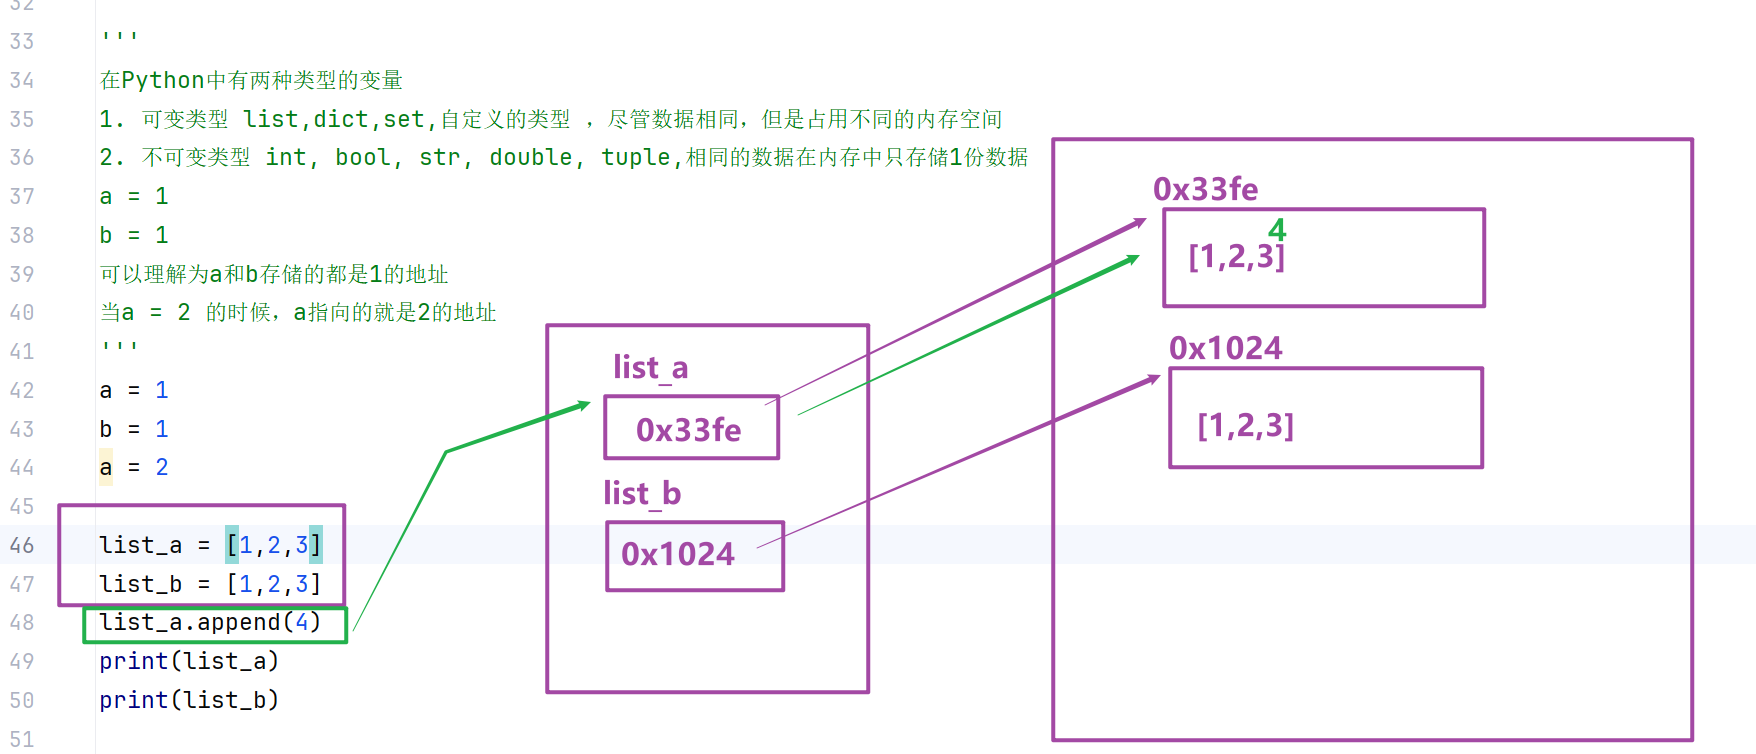
在Python中有两种类型的变量
1. 可变类型 list,dict,set,自定义的类型 ,尽管数据相同,但是占用不同的内存空间
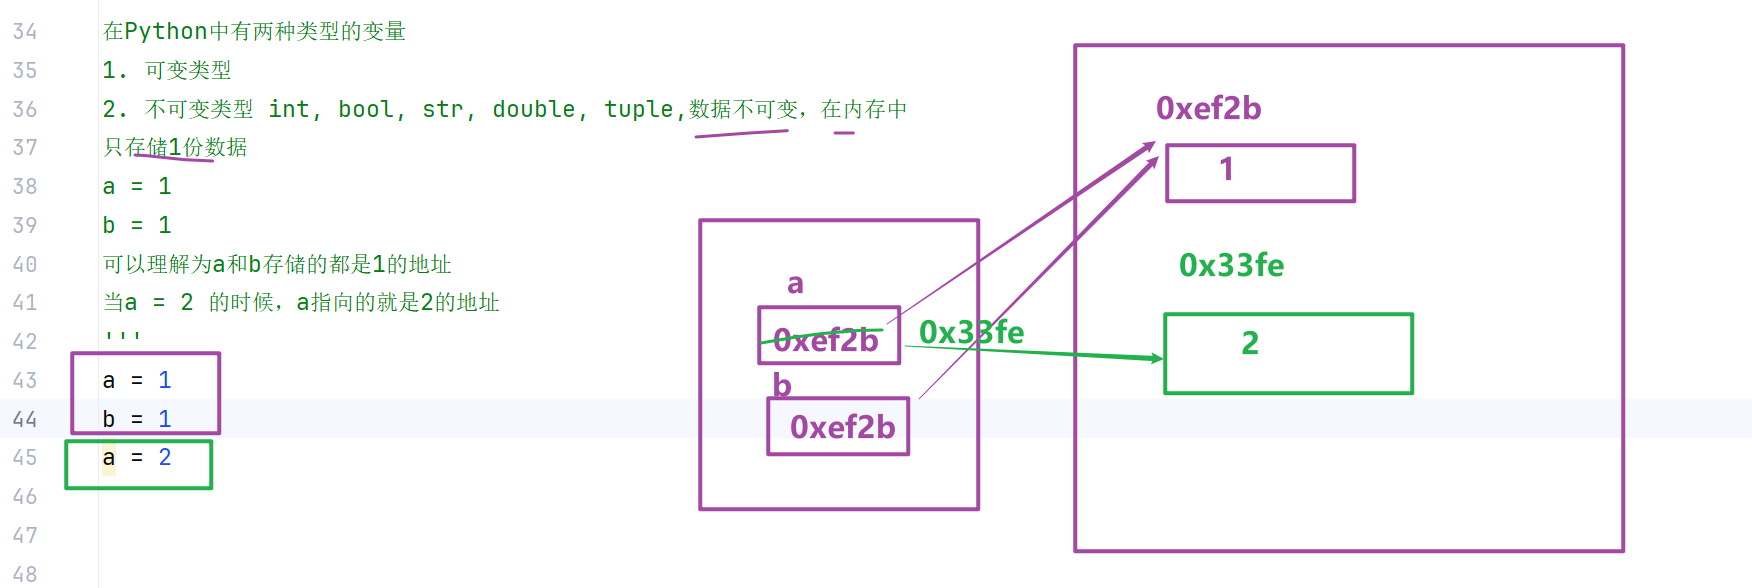
2. 不可变类型 int, bool, str, double, tuple,相同的数据在内存中只存储1份数据
a = 1
b = 1
可以理解为a和b存储的都是1的地址
当a = 2 的时候,a指向的就是2的地址
'''
a = 1
b = 1
a = 2

list_a = [1,2,3]
list_b = [1,2,3]
list_a.append(4)
print(list_a)
print(list_b)

'''
因为Python中赋值和定义具有二义性
Python不同于C++,
C++语法
int a = 100;  a = 200;
Python中
定义和赋值弄到一起
a = 100
a = 200
如果a = 200在函数内, a = 100在函数外
两个a 不是同一个a, 函数内的a = 200会被认为定义了一个新的变量a
'''

# 定义全局变量num = 10
num = 10
# 定义一个函数func
def func():
    # 尝试在函数内部修改全局变量,但是不会修改,只会重新定义一个num
    num = 20
    print(f"函数内num:{num}, id(num): {id(num)}")

# 调用函数func
func()
# 尝试访问全局变量num
print(f"函数外num:{num}, id(num): {id(num)}")
print('*'*20)
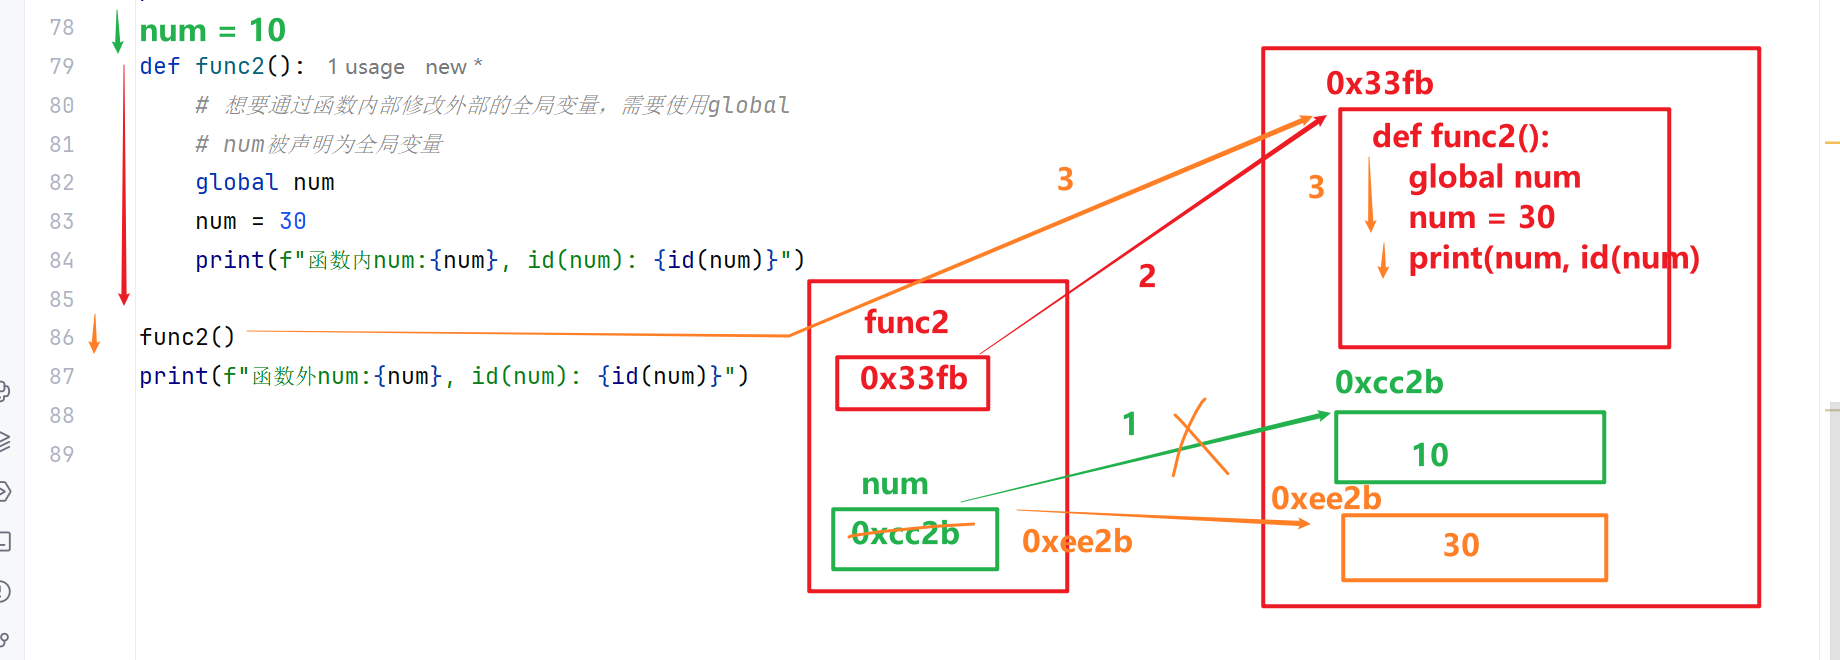
最终结果:弹出10,所以由运行结果可知,在函数体内部理论上是**没有办法对全局变量进行修改的,所以一定要进行修改,必须使用**<font style="color:#DF2A3F;">global</font>**关键字**。

# 定义全局变量num = 10
num = 10
# 定义一个函数func
def func():
    # 尝试在局部作用域中修改全局变量
    global num
    num = 20

# 调用函数func
func()
# 尝试访问全局变量num
print(num)
记住:global关键字只是针对不可变数据类型的变量进行修改操作(数值、字符串、布尔类型、元组类型),可变类型可以不加global关键字。
# 案例: 以卖票案例

# 1 定义一个票总量
ticket = 100


# 2- 定义一个卖票的程序(函数)
def sale_ticket():
    # 标记为全局变量: 主要是针对的是不可变的数据类型, 如果是可变的, 不需要添加global关键词
    # 不可变的数据类型: 数值 字符串 元组 布尔
    # 可变的数据类型:  列表 集合 字典
    global ticket

    # 执行一次, 需要让 票数 -1
    ticket -= 1  # 默认会认为这个变量是一个局部变量

    print(f"剩余票数为:{ticket}")


# 3- 调用卖票程序
sale_ticket()
sale_ticket()
sale_ticket()
sale_ticket()
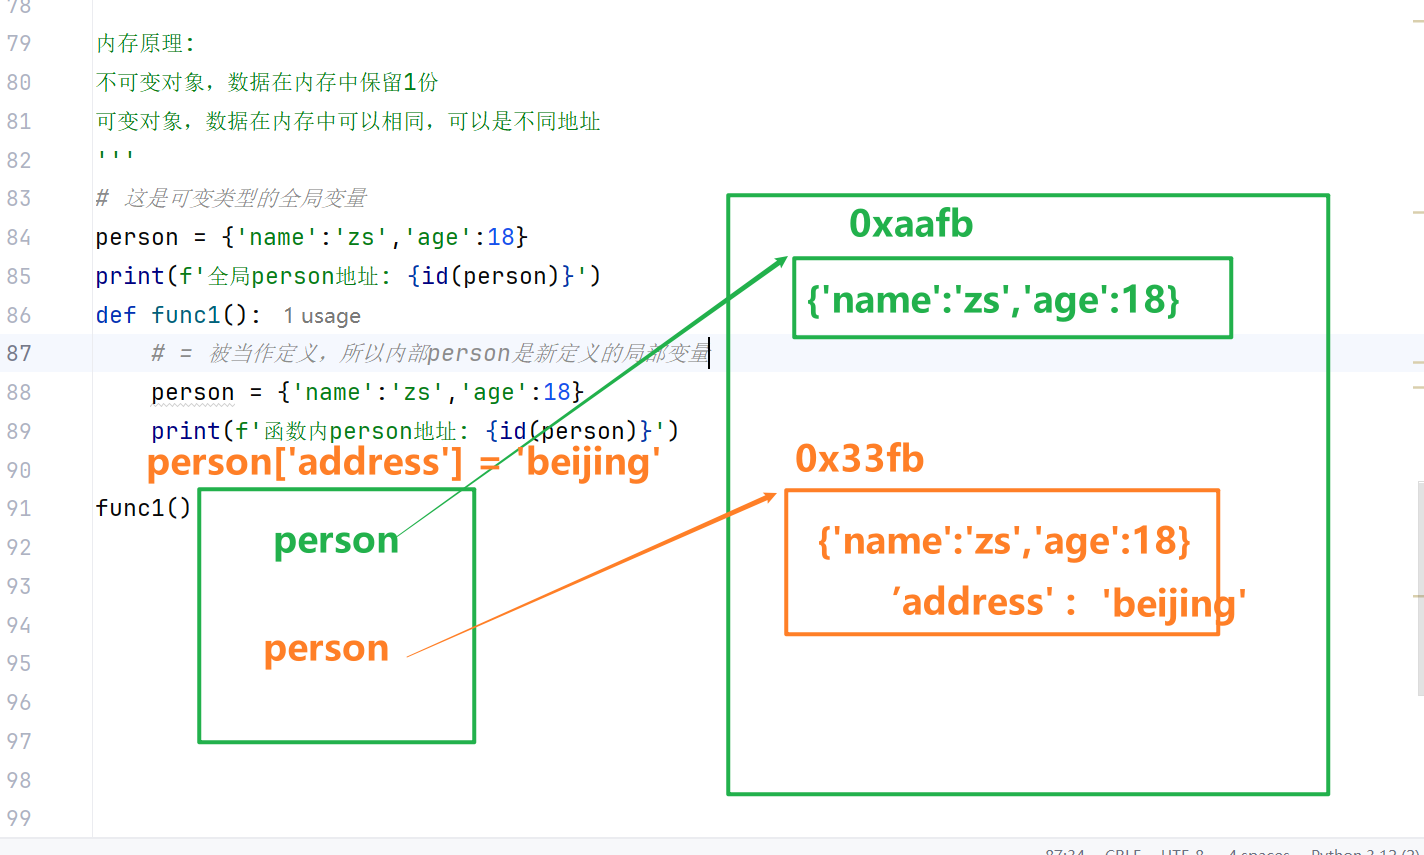
可变数据类型, 不需要添加global
# 结论: 如果变量的数据类型是可变的, 不需要添加global 就可以 对 全局变量进行修改

# 1- 定义一个全局变量: 类型为 字典
person = {"name":"张三","age":18}

# 2- 定义一个函数
def fun1():
    # 向字典中添加一个属性:
    person['address'] = "南京市"

    print(f"函数内打印全局变量:{person}")
    #print("修改全局变量的内容")


# 3- 调用函数
fun1()

# 4- 在全局范围内 打印全局变量
print(person)
'''
如果函数内修改的是可变对象,不需要加global,(dict,set,list,自定义类型对象)
因为不可变对象有很多种修改方式,比如字典的插入,比如列表append, remove,都可以修改,
不会被当成变量定义,所以就不用写global了

如果修改的是不可变的变量,需要加global,(字符串,元组,数字,布尔类型)
因为不可变类型的变量做修改,只能通过赋值,而赋值会产生二义性
python中=(赋值操作),有两层意思,一个是定义变量,还有一个是修改变量
在函数内部,局部作用域使用=,优先理解为定义变量

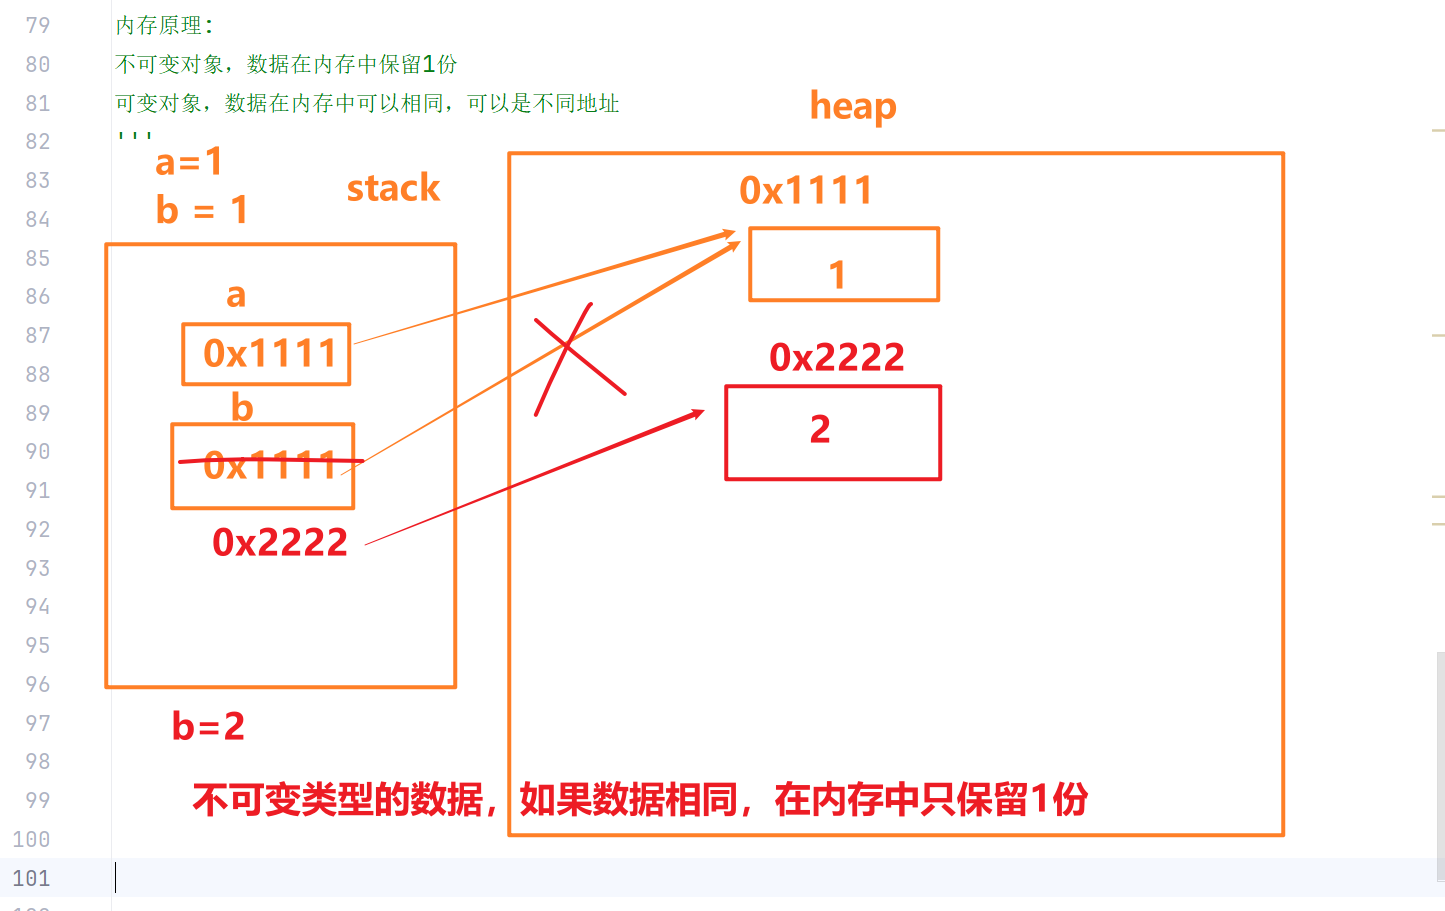
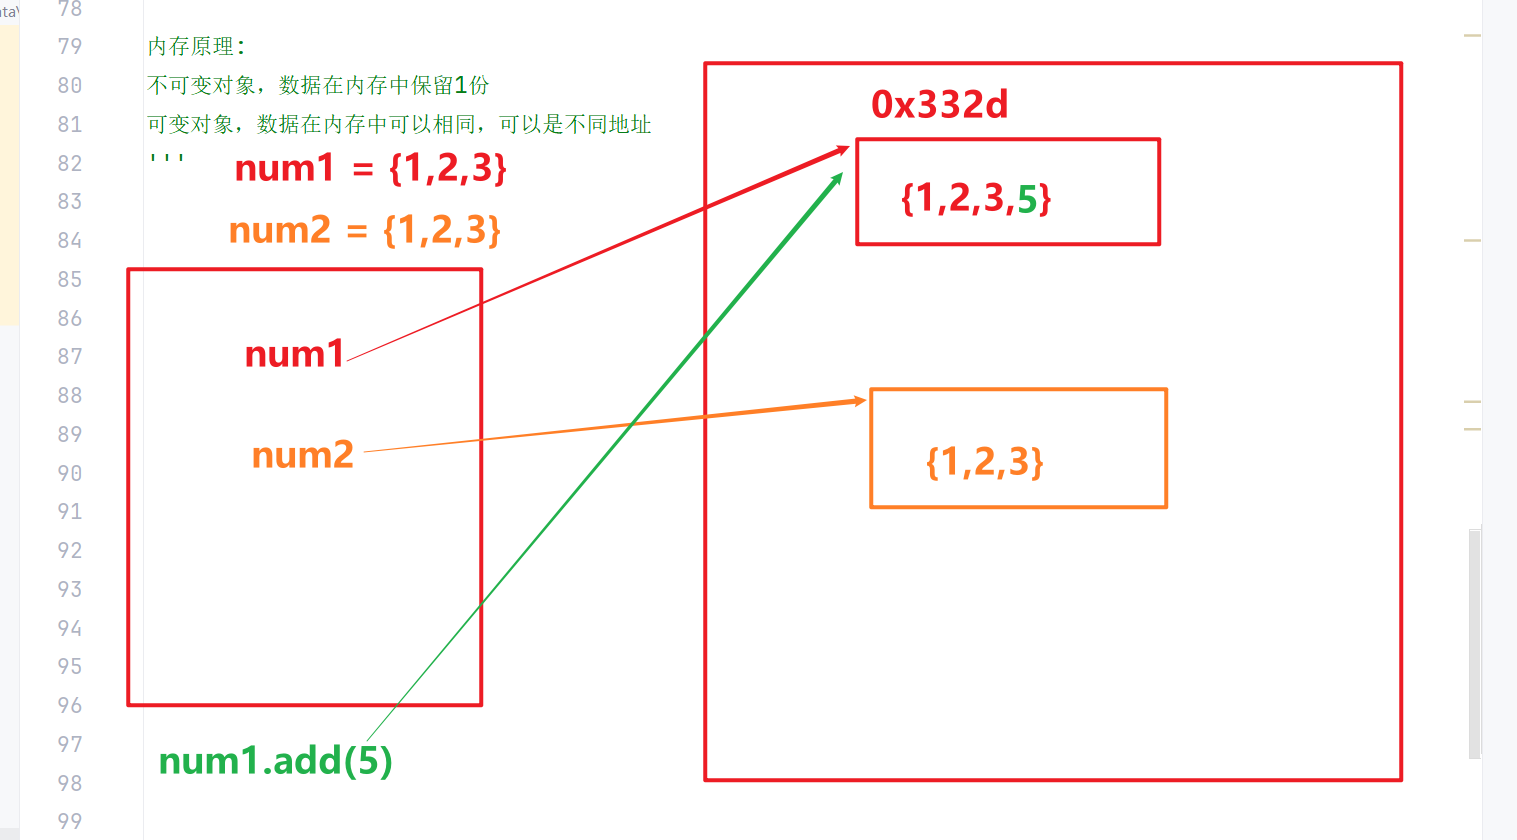
内存原理:
不可变对象,数据在内存中保留1份
可变对象,数据在内存中可以相同,可以是不同地址
'''
作用域说明完整源码
'''
局部作用域和全局作用域
'''
'''
局部作用域: 函数内部作用域就是局部作用域
全局作用域: 在函数外部的作用域就是全局作用域
局部变量: 在函数内部定义的变量就是局部变量,可见范围只在自己定义的作用域内,
在哪个函数内定义,就在哪个函数内可见,不可被外部的全局作用域使用
全局变量: 在函数外部定义的变量就是全局变量,可以被程序的所有部分使用
'''
# 全局变量
num1 = 2000
def hello():
    # 局部变量
    num2 = 300
    print('hello world')
# 全局变量
num3 = 400
def sum(num1,num2):
    # num1和num2都是局部变量,num4
    num4 = num1 + num2
    return num4

# 全局变量
str1 = 'hello'
def func():
    # 局部变量
    str2 = 'heima'
    print(f'在局部作用域内使用全局变量str1: {str1}')
    print(f'在局部作用域内使用局部变量str2: {str2}')

func()
# 在全局作用域内无法使用局部变量
#print(f'在全局作用域内使用局部变量str2: {str2}')

# 如果局部变量和全局变量同名了,就会出现定义局部变量和全局变量冲突的问题
# 如果想要在函数内修改外部局部变量,用global声明
# 全局变量
name = 'Lisi'
def change_name():
    # 局部变量
    name = 'zs'
    print(f'局部变量name: {name}')
change_name()
print(f'全局变量name: {name}')

# 使用global关键字
def change_name2():
    # 声明全局变量
    global name
    # 修改全局变量,将lisi改为zs
    name = 'zs'
    print(f'函数内name: {name}')
change_name2()
print(f'全局变量name: {name}')

# 全局变量
name = 'Lisi'
# 使用形参name
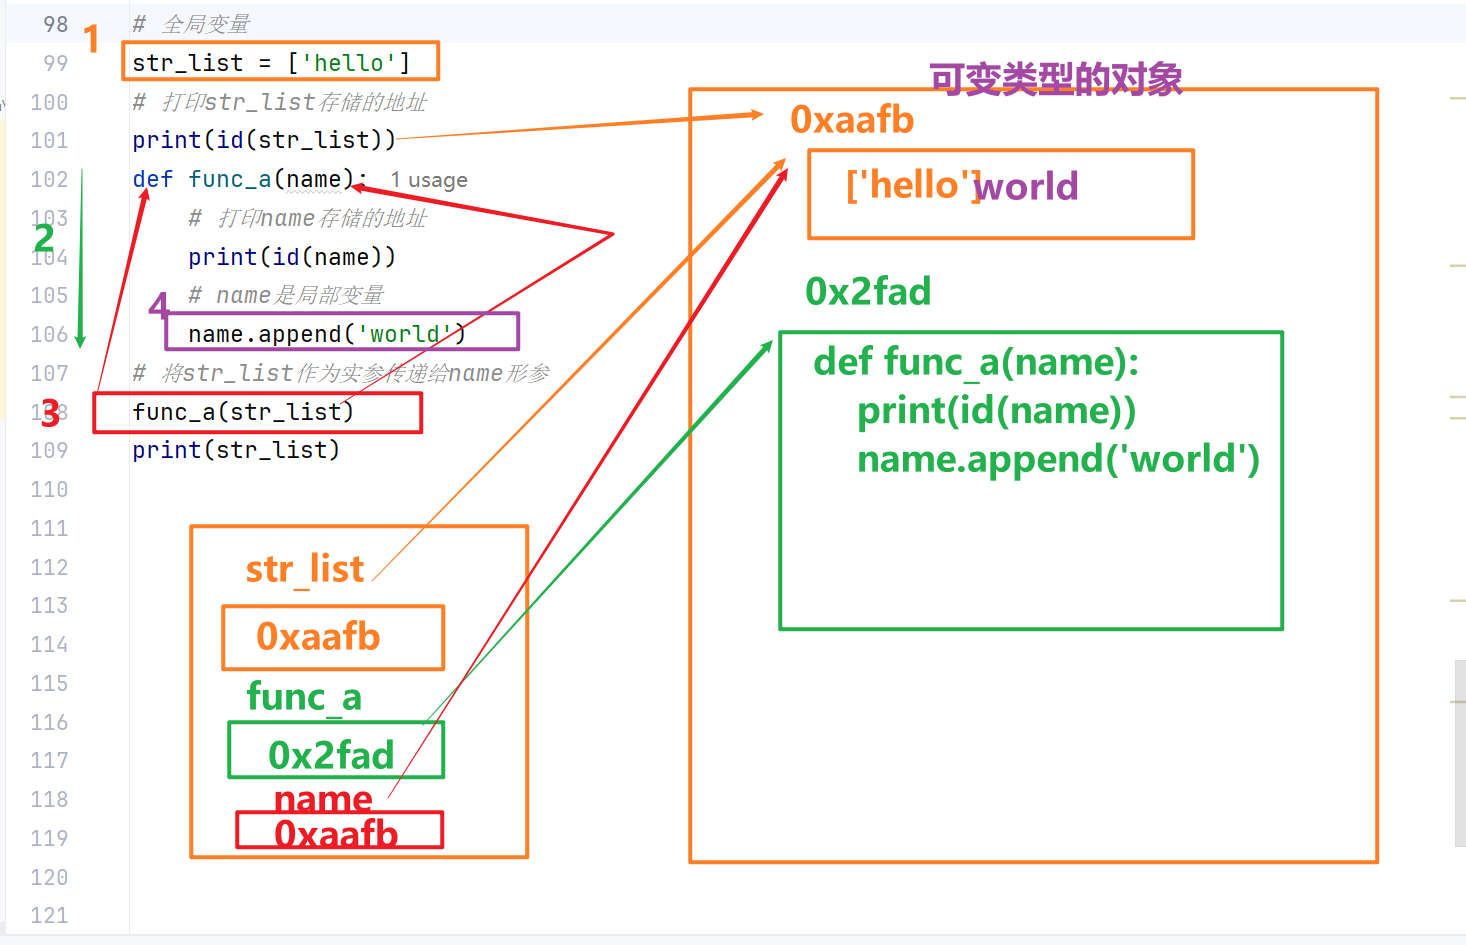
def change_name3(name):
    # name是形参,局部变量
    # 修改全局变量,将lisi改为zs
    name = 'zs'
    print(f'函数内name: {name}')
# name 为实参,为全局变量
change_name3(name)
print(f'全局变量name: {name}')

'''
如果函数内修改的是可变对象,不需要加global,(dict,set,list,自定义类型对象)
因为可变对象有很多种修改方式,比如字典的插入,比如列表append, remove,都可以修改,
不会被当成变量定义,所以就不用写global了

如果修改的是不可变的变量,需要加global,(字符串,元组,数字,布尔类型)
因为不可变类型的变量做修改,只能通过赋值,而赋值会产生二义性
python中=(赋值操作),有两层意思,一个是定义变量,还有一个是修改变量
在函数内部,局部作用域使用=,优先理解为定义变量

内存原理:
不可变对象,数据在内存中保留1份
可变对象,数据在内存中可以相同,可以是不同地址
'''
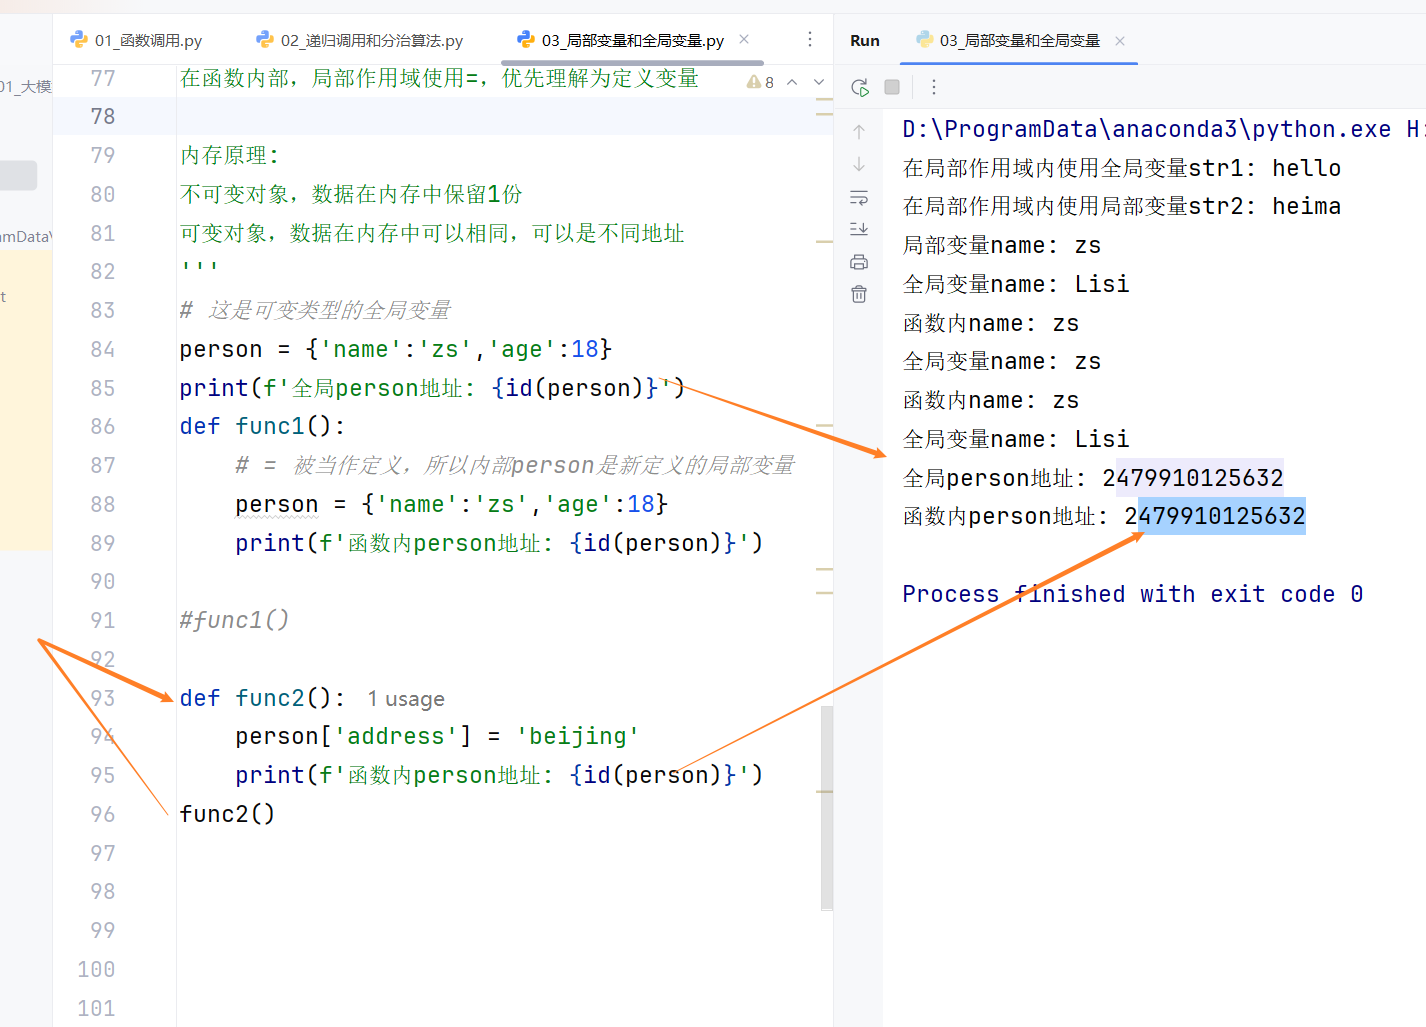
# 这是可变类型的全局变量
person = {'name':'zs','age':18}
print(f'全局person地址: {id(person)}')
def func1():
    # = 被当作定义,所以内部person是新定义的局部变量
    person = {'name':'zs','age':18}
    print(f'函数内person地址: {id(person)}')

#func1()

def func2():
    person['address'] = 'beijing'
    print(f'函数内person地址: {id(person)}')
func2()
函数的参数进阶
函数的参数
在函数定义与调用时,我们可以根据自己的需求来实现参数的传递。在Python中,函数的参数一共有两种形式:
① 形参 ② 实参
形参:在函数定义时,所编写的参数就称之为形式参数
实参:在函数调用时,所传递的参数就称之为实际参数

def greet(name):  # name就是在函数greet定义时,所编写的参数(形参)
    return name + ',您好'

# 调用函数
name = '老王'
greet(name)  # 在函数调用时,所传递的参数就是实际参数
注意:虽然我们在函数传递时,喜欢使用相同的名称作为参数名称。但是两者的作用范围是不同的。name = ‘老王’,代表实参。其是一个全局变量,而greet(name)函数中的name实际是在函数定义时才声明的变量,所以其实一个局部变量。
函数的参数类型(调用)

☆ 位置参数
理论上,在函数定义时,我们可以为其定义多个参数。但是在函数调用时,我们也应该传递多个参数,正常情况,其要一一对应。
def user_info(name, age, address):
    print(f'我的名字{name},今年{age}岁了,家里住在{address}')

# 调用函数
user_info('Tom', 23, '美国纽约')
注意事项:位置参数强调的是参数传递的位置必须一一对应,不能颠倒
☆ 关键词参数(Python特有)
函数调用,通过"键=值"形式加以指定。可以让函数更加清晰、容易使用,同时也清除了参数的顺序需求。
def user_info(name, age, address):
    print(f'我的名字{name},今年{age}岁了,家里住在{address}')

# 调用函数(使用关键词参数)
user_info(name='Tom', age=23, address='美国纽约')

☆ 函数定义时缺省参数(参数默认值)
缺省参数也叫默认参数,用于定义函数,为参数提供默认值,调用函数时可不传该默认参数的值(注意:所有位置参数必须出现在默认参数前,包括函数定义和调用)。
def user_info(name, age, gender='男'):
    print(f'我的名字{name},今年{age}岁了,我的性别为{gender}')


user_info('李林', 25)
user_info('振华', 28)
user_info('婉儿', 18, '女')
谨记:我们在定义缺省参数时,一定要把其写在参数列表的最后侧
相关的演示
# 定义一个函数, 该函数需要传入三个参数
def fun1(name,age,address):
    print(f"姓名:{name},年龄:{age},地址:{address}")


# 如何调用呢?
# 位置传参方式: 要求调用函数的时候, 传递的参数顺序 要和 函数的形参的顺序保持一致
fun1("张三",20,"南京市")

# 关键词传参: 在传递参数的时候, 可以指定给谁传递  对顺序就没有要求
fun1(age=18,name="李四",address="北京市")

# 默认值传参: 指的是在定义这个函数的时候, 可以给某些参数赋一个默认值, 然后在调用该函数就可以不需要传递参数了
# 注意: 有默认值的形参 必须放置到整个参数列表的最后面
def fun2(name,address='南京市',age=18):
    print(f"姓名:{name},年龄:{age},地址:{address}")

# 调用操作: 如果不需要修改默认值, 那么在调用的时候也不需要传递, 如果需要修改 那么就正常传递即可
fun2(name="王五")
fun2(name="赵六",address="北京市")


注意: 如果函数中某个参数没有默认值, 那么在调用的时候, 必须传递 否则会直接报错
不定长参数
不定长参数也叫可变参数。用于不确定调用的时候会传递多少个参数(不传参也可以)的场景。此时,可用包裹(packing)位置参数,或者包裹关键字参数,来进行参数传递,会显得非常方便。

☆ 不定长元组(位置)参数
def user_info(*args):
    # print(args)  # 元组类型数据,对传递参数有顺序要求
    print(f'我的名字{args[0]},今年{args[1]}岁了,住在{args[2]}')

# 调用函数,传递参数
user_info('Tom', 23, '美国纽约')
☆ 不定长字典(关键字)参数
def user_info(**kwargs):
    # print(kwargs)  # 字典类型数据,对传递参数没有顺序要求,格式要求key = value值
    print(f'我的名字{kwargs["name"]},今年{kwargs["age"]}岁了,住在{kwargs["address"]}')

# 调用函数,传递参数
user_info(name='Tom', address='美国纽约', age=23)
kw = keyword + args
综上:无论是包裹位置传递还是包裹关键字传递,都是一个组包的过程。
Python组包:就是把多个数据组成元组或者字典的过程。
相关演示:
# 演示不定长参数:
# 不定长元组(位置)参数
# 定义函数:
def fun1(*args):  # 这种 一个 * 不定长参数, 背后 是一个容器(序列) --> 元组
    # 获取每一个参数的内容
    print(type(args))
    for e in args:
        print(f"参数:{e}")


# 调用函数
fun1("张三", "李四", "王五", "赵六", "田七")


# 不定长字典(关键词)参数
def fun2(**kwargs):  # 这种 一个 ** 不定长参数, 背后 是一个容器(序列) --> 字典
    print(type(kwargs))
    # 遍历参数
    for key in kwargs:
        print(f"参数的key:{key}, 对应的值为:{kwargs[key]}")

# 调用函数: 必须使用关键词传参
fun2(name="张三", age=18, address="南京市")  # 在调用的时候, 创建了一个字典, 将 kv数据放置到了字典中

案例:Python中数据的传递案例
def func(*args, **kwargs):
    print(args)
    print(kwargs)


# 定义一个元组(也可以是列表)
tuple1 = (10, 20, 30)
# 定义一个字典
dict1 = {'first': 40, 'second': 50, 'third': 60}
# 需求:把元组传递给*args参数,字典传递给**kwargs
# ① 如果想把元组传递给*args,必须在tuple1的前面加一个*号
# ② 如果想把字典传递给**kwargs,必须在dict1的前面加两个**号
func(*tuple1, **dict1)
lambda函数

普通函数与匿名函数
在Python中,函数是一个被命名的、独立的完成特定功能的一段代码,并可能给调用它的程序一个返回值。
所以在Python中,函数大多数是有名函数 => 普通函数。但是有些情况下,我们为了简化程序代码,也可以定义匿名函数 => lambda表达式
lambda表达式应用场景
如果一个函数有一个返回值,并且只有一句代码,可以使用 lambda简化。
lambda表达式基本语法
变量 = lambda 函数参数:表达式(函数代码 + return返回值)
# 调用变量
变量()

编写lambda表达式
定义一个lambda表达式
'''
演示lambda表达式用法
'''

'''
变量 = lambda 函数参数:表达式(函数代码 + return返回值)
# 调用变量
变量()
说明:
变量就是函数的地址,将来可以通过变量名调用函数
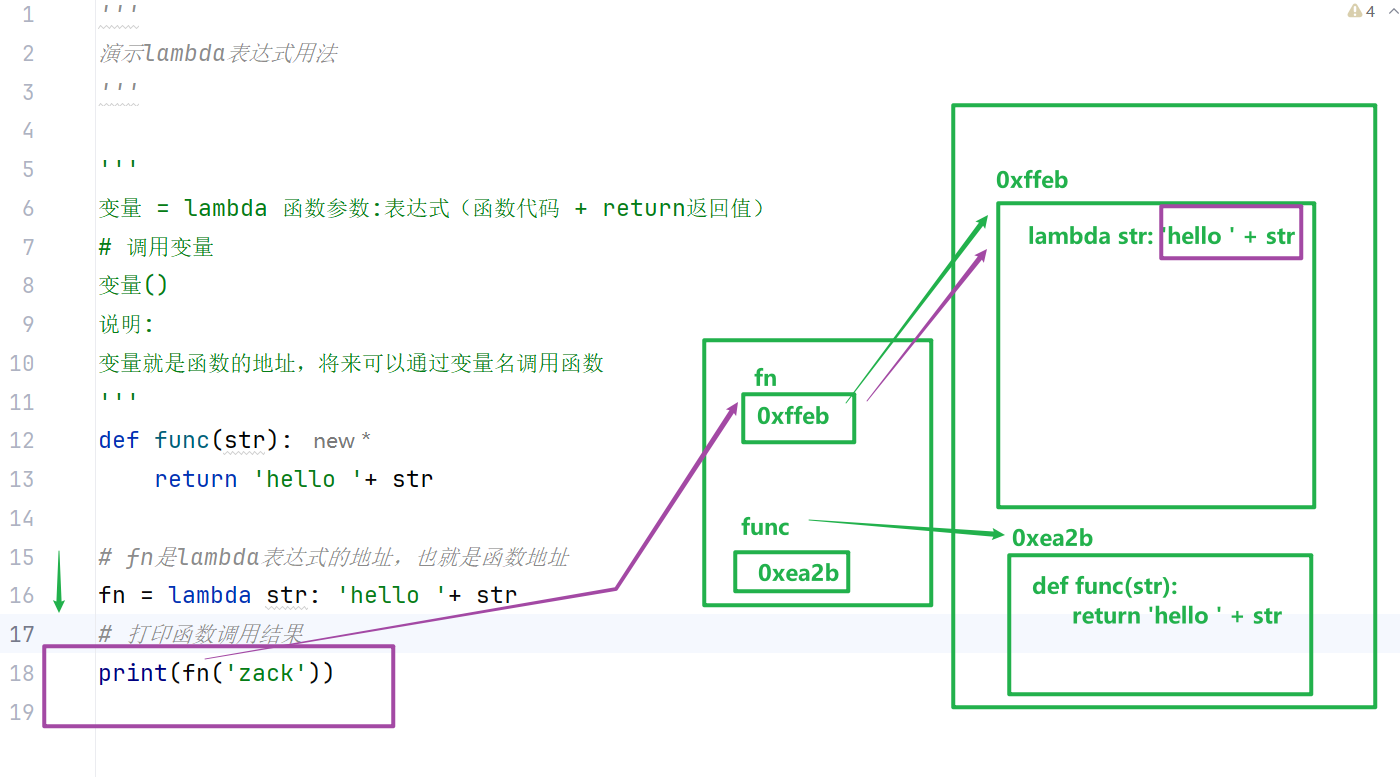
'''
def func(str):
    return 'hello '+ str

# fn是lambda表达式的地址,也就是函数地址
fn = lambda str: 'hello '+ str
# 打印函数调用结果
print(fn('zack'))
编写带参数的lambda表达式
编写一个函数求两个数的和
def fn1(num1, num2):
    return num1 + num2

print(fn1(10, 20))
lambda表达式进行简化:
'''
带参数的lambda表达式
计算num1和num2的加法结果
'''
# fn是lambda表达式的地址,也就是函数地址
fn = lambda num1,num2:num1+num2
# 函数调用
print(fn(1,2))
☆ 带默认参数的lambda表达式
# 有参数 参数带有默认值:
def fn2(num1, num2=30):
    return num1 + num2


print(fn2)
print(fn2(10))

# lambda 简化
'''
带默认值的参数
'''
fn2 = lambda num1, num2=20: num1-num2
# 打印函数的地址,也就是lambda表达式在堆区的地址
print(fn2)
# num2默认传递20
print(fn2(100))
☆ 带if判断(三目运算符)的lambda表达式
# 带 if判断(三目运算符)的lambda表达式
# 普通函数
def fn3(name: str):
    a = 0
    if name == "张三":
        a = 1
    else:
        a = 0
    return a

# 普通函数
def fn4(name: str):
    return 1 if name == "张三" else 0

print(fn4("李四"))

# 基于lambda方案实现
lambda name: 1 if name == '张三' else 0
☆ 列表数据+字典数据排序(重点)
lambda表达式经常配合泛型编程使用
不受限于数据结构
也不受限于实际参数
封装和调用解耦合

知识点:列表.sort(key=排序的key)
print("------------------------------------")
# 在一个列表中, 放置了三个元素, 每一个元素又是一个字典
students = [
    {'name': 'Tom', 'age': 20},
    {'name': 'Rose', 'age': 19},
    {'name': 'Jack', 'age': 22}
]
print(students)
# 按name值升序排列

# 按name值降序排列
本章知识总结

| 知识点 | 核心语法 | 一句话总结 |
|---|---|---|
| 拆包 | a, b = b, a | 一步交换,无需临时变量 |
| 推导式 | [x for x in seq if cond] | 一行代码替代for循环 |
| 函数 | def name(params): ... return | 封装复用,模块化编程 |
| 递归 | def f(n): return n * f(n-1) | 函数自调用,必须有出口 |
| 作用域 | global / local | 函数内修改全局不可变需global |
| 不定长参数 | *args / **kwargs | 接收任意数量参数 |
| lambda | lambda x: x * 2 | 单行函数的匿名写法 |
文件操作与异常处理
文件操作、异常处理与模块化编程

文件读写基础
为什么要学文件操作?
程序运行时的数据存储在内存中,程序结束后数据就消失了。文件操作让我们能够:
- 数据持久化:保存数据到硬盘
- 数据读取:读取之前保存的数据
- 大数据处理:处理超过内存容量的数据
- 日志记录:记录程序运行过程

文件操作的三个步骤

open() 函数详解
基本语法
open(filename, mode, encoding)
参数说明
| 参数 | 说明 | 示例 |
|---|---|---|
| filename | 文件名或路径 | 'example.txt', './data/file.txt' |
| mode | 打开模式 | 'r', 'w', 'a', 'x' |
| encoding | 编码方式 | 'utf-8', 'gbk' |
打开模式详解

| 模式 | 含义 | 文件存在 | 文件不存在 |
|---|---|---|---|
'r' | 读取(默认) | 打开 | 报错 |
'w' | 写入 | 覆盖 | 创建 |
'a' | 追加 | 追加 | 创建 |
'x' | 创建 | 报错 | 创建 |
最简单的文件读取
# 方式1:一次性读取全部内容
with open('example.txt', 'r', encoding='utf-8') as f:
    content = f.read()
print(content)
为什么使用 with 语句?

- 自动打开文件
- 自动关闭文件
- 即使发生错误也会关闭文件
- 代码更简洁
四种读取方式

方式1:read() - 一次性读取全部
with open('example.txt', 'r', encoding='utf-8') as f:
    content = f.read()  # 返回字符串
适用场景:小文件,需要全部内容
风险:大文件会占用大量内存
方式2:readline() - 逐行读取
with open('example.txt', 'r', encoding='utf-8') as f:
    line = f.readline()  # 读取一行
    while line:
        print(line.rstrip('\n'))  # 移除换行符
        line = f.readline()
适用场景:需要逐行处理
优点:内存占用少
方式3:readlines() - 读取所有行到列表
with open('example.txt', 'r', encoding='utf-8') as f:
    lines = f.readlines()  # 返回列表
    for i, line in enumerate(lines):
        print(f"第{i+1}行: {line.rstrip()}")
适用场景:需要随机访问行
风险:大文件占用内存
方式4:迭代读取(最推荐)
with open('example.txt', 'r', encoding='utf-8') as f:
    for line in f:  # 最高效的方式
        print(line.rstrip('\n'))
优点:
- 内存效率最高
- 代码最简洁
- 最Pythonic
处理大文件
分块读取
def read_large_file_by_chunks(filename, chunk_size=1024):
    """分块读取大文件"""
    with open(filename, 'r', encoding='utf-8') as f:
        while True:
            chunk = f.read(chunk_size)
            if not chunk:
                break
            process_data(chunk)
按行分块读取
def read_large_file_by_lines(filename, batch_size=1000):
    """按行分块读取大文件"""
    batch = []
    with open(filename, 'r', encoding='utf-8') as f:
        # 从文件中按照行读取
        for line in f:
            batch.append(line.rstrip('\n'))
            if len(batch) == batch_size:
                process_batch(batch)
                batch = []
        if batch:
            process_batch(batch)
文件写入
写入模式

# 模式1:写入(覆盖)
with open('output.txt', 'w', encoding='utf-8') as f:
    f.write('第一行\n')
    f.write('第二行\n')

# 模式2:追加
with open('output.txt', 'a', encoding='utf-8') as f:
    f.write('追加的内容\n')

# 模式3:使用 print() 函数
with open('output.txt', 'w', encoding='utf-8') as f:
    print('第一行', file=f)
    print('第二行', file=f)
写入列表
lines = ['第一行\n', '第二行\n', '第三行\n']
with open('output.txt', 'w', encoding='utf-8') as f:
    f.writelines(lines)
文件指针操作

with open('example.txt', 'r', encoding='utf-8') as f:
    # tell() - 获取当前位置
    print(f.tell())  # 0

    # 读取 10 个字符
    content = f.read(10)
    print(f.tell())  # 10

    # seek() - 移动指针
    f.seek(0)  # 回到开头
    f.seek(5, 0)  # 从开头移动 5 字节

    # 获取文件大小
    f.seek(0, 2)
    file_size = f.tell()
处理 CSV 文件
# 读取 CSV
def read_csv(filename):
    students = []
    with open(filename, 'r', encoding='utf-8') as f:
        f.readline()  # 跳过表头
        for line in f:
            name, age, score = line.rstrip('\n').split(',')
            students.append({
                'name': name,
                'age': int(age),
                'score': int(score)
            })
    return students

# 写入 CSV
def write_csv(filename, students):
    with open(filename, 'w', encoding='utf-8') as f:
        f.write('name,age,score\n')
        for student in students:
            line = f"{student['name']},{student['age']},{student['score']}\n"
            f.write(line)
处理 JSON 文件
import json

# 读取 JSON
def read_json(filename):
    with open(filename, 'r', encoding='utf-8') as f:
        data = json.load(f)
    return data

# 写入 JSON
def write_json(filename, data):
    with open(filename, 'w', encoding='utf-8') as f:
        json.dump(data, f, indent=2, ensure_ascii=False)
异常处理
什么是异常?
异常是程序执行过程中发生的错误事件。

常见异常类型:
FileNotFoundError- 文件不存在PermissionError- 没有权限ValueError- 值错误TypeError- 类型错误ZeroDivisionError- 除以零IndexError- 索引超出范围KeyError- 字典键不存在
为什么需要异常处理?
- 防止程序崩溃 - 程序可以继续运行
- 提供有意义的错误信息 - 帮助用户理解问题
- 采取恢复措施 - 尝试其他方法或保存数据
基础异常处理:try-except
基本结构
try:
    # 可能出错的代码
except 异常类型:
    # 处理异常的代码
示例1:捕获特定异常
def safe_divide(a, b):
    try:
        result = a / b
    except ZeroDivisionError:
        print("错误:不能除以零")
        return None
    return result

print(safe_divide(10, 2))   # 5.0
print(safe_divide(10, 0))   # 错误:不能除以零
示例2:文件操作中的异常处理
def safe_read_file(filename):
    try:
        with open(filename, 'r', encoding='utf-8') as f:
            content = f.read()
        return content
    except FileNotFoundError:
        print(f"错误:文件 '{filename}' 不存在")
        return None
捕获多个异常
方式1:多个 except 块
try:
    with open(filename, 'r', encoding='utf-8') as f:
        content = f.read()
except FileNotFoundError:
    print("错误:文件不存在")
except PermissionError:
    print("错误:没有权限")
except UnicodeDecodeError:
    print("错误:编码错误")
方式2:一个 except 块捕获多个异常
try:
    with open(filename, 'r', encoding='utf-8') as f:
        content = f.read()
except (FileNotFoundError, PermissionError):
    print("错误:文件访问失败")
获取异常信息
try:
    with open('nonexistent.txt', 'r') as f:
        content = f.read()
except FileNotFoundError as e:
    print(f"异常类型: {type(e)}")
    print(f"异常信息: {e}")
完整的异常处理结构

try:
    # 可能出错的代码
    with open('example.txt', 'r', encoding='utf-8') as f:
        content = f.read()
except FileNotFoundError:
    print("错误:文件不存在")
except Exception as e:
    print(f"发生错误: {e}")
else:
    # 只有在 try 块成功执行时才运行
    print(f"文件读取成功,内容长度: {len(content)} 字符")
finally:
    # 无论如何都会执行
    print("文件操作完成")
执行流程:
- 执行 try 块
- 如果发生异常,执行对应的 except 块
- 如果没有异常,执行 else 块
- 无论如何,最后执行 finally 块
finally 块的重要用途
f = None
try:
    f = open('example.txt', 'r', encoding='utf-8')
    content = f.read()
except FileNotFoundError:
    print("错误:文件不存在")
finally:
    # 即使发生异常,这里也会执行
    if f is not None:
        f.close()
        print("文件已关闭")
注意:这种方式不如 with 语句安全,推荐使用 with 语句。
异常的传播
def func2():
    x = 1 / 0  # 这里会抛出异常

def func1():
    func2()  # 异常会从这里传播出去

def main():
    try:
        func1()
    except ZeroDivisionError:
        print("捕获到异常:除以零")

main()
异常传播链:
main()
↓
func1()
↓
func2() (异常发生)
↓
func1() (没有处理,继续传播)
↓
main() (捕获异常)
实战:安全的文件读写
def safe_read_file(filename):
    """完整的安全文件读取函数"""
    try:
        with open(filename, 'r', encoding='utf-8') as f:
            content = f.read()
        return content
    except FileNotFoundError:
        print(f"错误:文件 '{filename}' 不存在")
        return None
    except PermissionError:
        print(f"错误:没有权限读取文件 '{filename}'")
        return None
    except UnicodeDecodeError:
        print(f"错误:文件编码错误,尝试使用 GBK 编码")
        try:
            with open(filename, 'r', encoding='gbk') as f:
                content = f.read()
            return content
        except:
            return None
    except IOError as e:
        print(f"错误:I/O 错误 - {e}")
        return None

def safe_write_file(filename, content):
    """完整的安全文件写入函数"""
    try:
        with open(filename, 'w', encoding='utf-8') as f:
            f.write(content)
        print(f"成功写入文件 '{filename}'")
        return True
    except PermissionError:
        print(f"错误:没有权限写入文件 '{filename}'")
        return False
    except IOError as e:
        print(f"错误:写入失败 - {e}")
        return False
包与模块管理
模块与包的概念

模块(Module)
- 单个
.py文件 - 包含 Python 代码
- 可以被导入使用
包(Package)
- 包含
__init__.py文件的目录 - 可以包含多个模块和子包
- 用于组织相关的模块
最小包结构
myproject/
├── mypackage/
│   ├── __init__.py
│   └── module.py
└── main.py
完整包结构
myproject/
├── README.md
├── setup.py
├── requirements.txt
├── mypackage/
│   ├── __init__.py
│   ├── core/
│   │   ├── __init__.py
│   │   ├── engine.py
│   │   └── utils.py
│   ├── io/
│   │   ├── __init__.py
│   │   ├── reader.py
│   │   └── writer.py
│   └── config.py
├── tests/
│   ├── __init__.py
│   └── test_core.py
└── examples/
    └── example.py

init.py 的作用
作用1:标记目录为包
# 有 __init__.py 的目录被识别为包
# 没有 __init__.py 的目录不是包
作用2:初始化包
# mypackage/__init__.py
print("mypackage 已加载")
作用3:定义公共接口
# mypackage/__init__.py
from .core import engine
from .io import reader

__all__ = ['engine', 'reader']
导入方式

方式1:导入整个模块
import mypackage.core.engine
engine_obj = mypackage.core.engine.Engine()
方式2:导入特定内容
from mypackage.core.engine import Engine
engine_obj = Engine()
方式3:导入子包
from mypackage.core import engine
engine_obj = engine.Engine()
方式4:相对导入(仅在包内使用)
# 在 mypackage/io/reader.py 中
from . import writer  # 导入同级模块
from ..core import engine  # 导入上级包的模块
创建自定义包
步骤1:创建目录结构
mkdir datatools
mkdir datatools/core
mkdir datatools/io
mkdir datatools/utils
步骤2:创建 init.py 文件
# datatools/__init__.py
__version__ = "1.0.0"

from .core import processor
from .io import reader, writer

__all__ = ['processor', 'reader', 'writer']
步骤3:创建模块文件
# datatools/core/processor.py
def process_data(data):
    """处理数据"""
    return data
# datatools/io/reader.py
def read_file(filename):
    """读取文件"""
    with open(filename, 'r', encoding='utf-8') as f:
        return f.read()
步骤4:使用包
import datatools
from datatools import processor, reader

data = reader.read_file('data.txt')
result = processor.process_data(data)
setup.py - 包的安装配置
from setuptools import setup, find_packages

setup(
    name='datatools',
    version='1.0.0',
    description='数据处理工具包',
    author='Your Name',
    author_email='your.email@example.com',
    url='https://github.com/yourusername/datatools',
    license='MIT',
    packages=find_packages(),
    python_requires='>=3.7',
    install_requires=[
        'numpy>=1.19.0',
    ],
    classifiers=[
        'Development Status :: 4 - Beta',
        'Intended Audience :: Developers',
        'License :: OSI Approved :: MIT License',
        'Programming Language :: Python :: 3',
    ],
)
安装包
# 本地开发安装(推荐)
pip install -e .

# 普通安装
pip install .

# 从 PyPI 安装
pip install datatools

# 指定版本
pip install datatools==1.0.0
requirements.txt
# requirements.txt
numpy>=1.19.0
pandas>=1.1.0
requests>=2.25.0
使用方式:
pip install -r requirements.txt
实战项目

项目1:学生成绩管理系统
项目结构
grade_system/
├── main.py
├── students.csv
└── utils.py
main.py
import csv
import json

def read_students_csv(filename):
    """读取学生信息"""
    students = []
    try:
        with open(filename, 'r', encoding='utf-8') as f:
            reader = csv.DictReader(f)
            for row in reader:
                students.append({
                    'name': row['name'],
                    'age': int(row['age']),
                    'score': float(row['score'])
                })
        return students
    except FileNotFoundError:
        print(f"错误:文件 '{filename}' 不存在")
        return []
    except ValueError:
        print("错误:数据格式错误")
        return []

def calculate_average(students):
    """计算平均成绩"""
    if not students:
        return 0
    total = sum(s['score'] for s in students)
    return total / len(students)

def find_top_student(students):
    """找出成绩最高的学生"""
    if not students:
        return None
    return max(students, key=lambda s: s['score'])

def save_report(filename, students):
    """保存成绩报告"""
    try:
        report = {
            'total_students': len(students),
            'average_score': calculate_average(students),
            'top_student': find_top_student(students),
            'students': students
        }
        with open(filename, 'w', encoding='utf-8') as f:
            json.dump(report, f, indent=2, ensure_ascii=False)
        print(f"报告已保存到 '{filename}'")
    except IOError as e:
        print(f"错误:保存报告失败 - {e}")

def main():
    """主函数"""
    # 读取学生信息
    students = read_students_csv('students.csv')

    if not students:
        print("没有学生数据")
        return

    # 显示统计信息
    print(f"总学生数:{len(students)}")
    print(f"平均成绩:{calculate_average(students):.2f}")

    top = find_top_student(students)
    if top:
        print(f"最高成绩:{top['name']} - {top['score']}")

    # 保存报告
    save_report('report.json', students)

if __name__ == '__main__':
    main()

项目2:日志记录系统
项目结构
log_system/
├── main.py
├── logger.py
└── logs/
logger.py
import os
from datetime import datetime

def create_log_file(log_dir='logs'):
    """创建日志目录"""
    if not os.path.exists(log_dir):
        os.makedirs(log_dir)
    return log_dir

def write_log(message, log_dir='logs', level='INFO'):
    """写入日志"""
    try:
        # 创建日志目录
        create_log_file(log_dir)

        # 生成日志文件名
        today = datetime.now().strftime('%Y-%m-%d')
        log_file = os.path.join(log_dir, f'{today}.log')

        # 生成日志内容
        timestamp = datetime.now().strftime('%Y-%m-%d %H:%M:%S')
        log_content = f"[{timestamp}] [{level}] {message}\n"

        # 写入日志
        with open(log_file, 'a', encoding='utf-8') as f:
            f.write(log_content)

        print(f"日志已记录:{log_content.strip()}")
    except IOError as e:
        print(f"错误:写入日志失败 - {e}")

def read_logs(log_dir='logs', date=None):
    """读取日志"""
    try:
        if date is None:
            date = datetime.now().strftime('%Y-%m-%d')

        log_file = os.path.join(log_dir, f'{date}.log')

        if not os.path.exists(log_file):
            print(f"日志文件不存在:{log_file}")
            return []

        with open(log_file, 'r', encoding='utf-8') as f:
            logs = f.readlines()

        return logs
    except IOError as e:
        print(f"错误:读取日志失败 - {e}")
        return []

def main():
    """主函数"""
    # 写入日志
    write_log("程序启动", level='INFO')
    write_log("开始处理数据", level='INFO')

    try:
        # 模拟处理
        result = 10 / 0
    except ZeroDivisionError:
        write_log("发生错误:除以零", level='ERROR')

    write_log("程序结束", level='INFO')

    # 读取日志
    logs = read_logs()
    print("\n今日日志:")
    for log in logs:
        print(log.strip())

if __name__ == '__main__':
    main()
项目3:配置文件管理
项目结构
config_system/
├── main.py
├── config.json
└── config_manager.py
config_manager.py
import json
import os

def load_config(filename):
    """加载配置文件"""
    try:
        with open(filename, 'r', encoding='utf-8') as f:
            config = json.load(f)
        print(f"配置已加载:{filename}")
        return config
    except FileNotFoundError:
        print(f"错误:配置文件不存在 - {filename}")
        return {}
    except json.JSONDecodeError:
        print(f"错误:配置文件格式错误 - {filename}")
        return {}

def save_config(filename, config):
    """保存配置文件"""
    try:
        with open(filename, 'w', encoding='utf-8') as f:
            json.dump(config, f, indent=2, ensure_ascii=False)
        print(f"配置已保存:{filename}")
        return True
    except IOError as e:
        print(f"错误:保存配置失败 - {e}")
        return False

def get_config_value(config, key, default=None):
    """获取配置值"""
    return config.get(key, default)

def set_config_value(config, key, value):
    """设置配置值"""
    config[key] = value
    return config

def main():
    """主函数"""
    config_file = 'config.json'

    # 加载配置
    config = load_config(config_file)

    if not config:
        # 创建默认配置
        config = {
            'app_name': 'MyApp',
            'version': '1.0.0',
            'debug': True,
            'port': 8000
        }
        save_config(config_file, config)

    # 获取配置值
    app_name = get_config_value(config, 'app_name')
    print(f"应用名称:{app_name}")

    # 修改配置
    config = set_config_value(config, 'debug', False)
    save_config(config_file, config)

if __name__ == '__main__':
    main()
本章知识总结

| 知识点 | 核心语法 | 一句话总结 |
|---|---|---|
| 文件读取 | with open(f,'r') as f: content=f.read() | with 自动管理文件关闭 |
| 四种读取方式 | read() / readline() / readlines() / for line in f | 优先使用 for line in f |
| 文件写入 | f.write() / f.writelines() | w 覆盖, a 追加, x 创建 |
| 文件指针 | tell() / seek(offset, whence) | 可随机访问文件任意位置 |
| CSV处理 | split(',') / csv.DictReader | 结构化数据存储 |
| JSON处理 | json.load() / json.dump() | 支持嵌套结构 |
| try-except | try: ... except XxxError: ... | 防止程序崩溃 |
| else-finally | else: (无异常) / finally: (必执行) | 完整的异常处理 |
| 异常传播 | 未捕获的异常沿调用栈向上传播 | 在最外层统一处理 |
| 模块 | 单 .py 文件 | import module |
| 包 | 含 __init__.py 的目录 | from pkg import mod |
| pip安装 | pip install -e . / pip install pkg | 开发和发布模式 |
这里是“一人公司”的成长家园。我们提供从产品曝光、技术变现到法律财税的全栈内容,并连接云服务、办公空间等稀缺资源,助你专注创造,无忧运营。
更多推荐
 8
 0
- 0


 已为社区贡献1条内容

所有评论(0)