Ragent项目 day-04 文档解析与分块
RAG 是一套基于向量数据库的检索增强流程,它负责把文档切分、向量化并存入库,用户提问时,从向量库找出最相关的知识片段,把这些资料和问题一起拼进提示词交给大模型,让模型依据真实资料回答,避免幻觉。
Agent 相当于是一个决策与调度程序,它会判断用户意图,决定什么时候调用 RAG、什么时候调用工具,什么时候需要重构用户问题,也可以自主决定是否需要多次检索、多次追问大模型,直到把任务完成。
Skill 就是 Agent 可以使用的 “技能组合”,本质是一系列固定或可传参的执行步骤,相当于 Agent 的手脚。比如一个擅长作图的 Agent,它的 Skill 里会包含各种作图相关的操作流程。Skill 可以是固定步骤,比如固定从坐标 1.1 到 9.9 画一条线;也可以设计成支持参数的通用能力,让 Agent 传入不同起点、终点,就能画出任意线段。
- RAG = 查资料
- Agent = 做决策
- Skill/Tool = 动手执行
- Prompt = 发指令
- Memory = 记上下文
- 流式输出 = 给用户看效果
用Apache Tika解析文档
读文件:
1.1 PDF:同一个后缀,完全不同的内心
同样是 .pdf 后缀,内部结构可能完全不同:
-
文字型 PDF:内部存储的是文字编码,可以直接提取。
-
扫描型 PDF:内部存储的是图片,文字只是“画”上去的。
-
混合型 PDF:部分页是文字,部分页是扫描图。
-
如果文档解析这一步出了问题
问题
后果
扫描 PDF 解析为空
这份文档的知识完全丢失
表格变成乱换行
检索时匹配不到,或者匹配到无意义片段
元数据丢失
用户问“这是哪个部门的文件”,你答不上来
乱码
向量化结果是垃圾,检索结果也是垃圾
页眉页脚混入
每个切片都带着“第X页/共Y页”,浪费 token
-
认识 Apache Tika
1. Tika 解决什么问题
-
能自动识别文件的真实类型(不靠后缀)
-
能处理几十种文档格式(PDF、Word、PPT、Excel、HTML、邮件...)
-
能提取文本内容。
-
能提取元数据(作者、创建时间、标题...)
-
能处理编码问题。
-
能对接 OCR(处理扫描件)
-
最好是开源免费的。
-
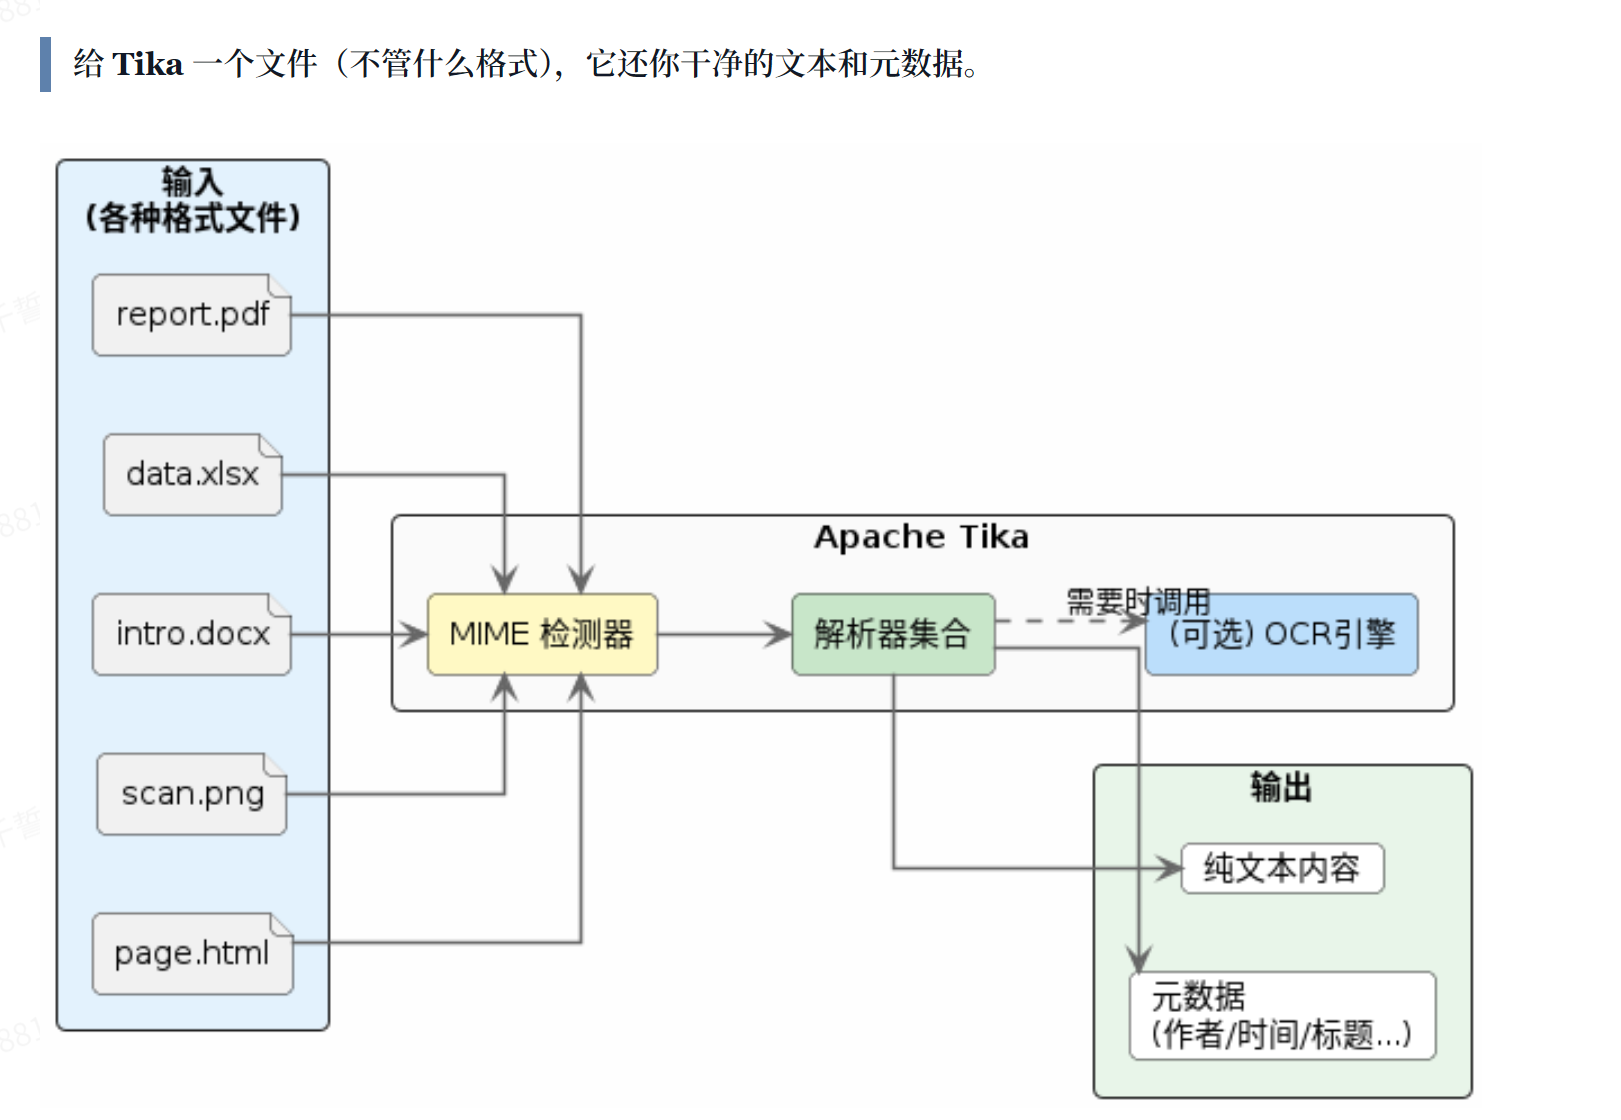
3. 两种使用方式
|
方式 |
说明 |
适用场景 |
|---|---|---|
|
作为 Java 依赖库 |
直接在项目中引入 |
单体应用、解析量不大、对延迟敏感 |
|
作为独立服务(Tika Server) |
用 Docker 跑一个 Tika 服务,通过 HTTP 接口调用 |
微服务架构、多语言、需要隔离、解析量大 |
2.3 文本抽取在 RAG 中的价值:从各种格式的文件中,提取出纯文本内容。
|
用途 |
说明 |
|---|---|
|
向量化 |
只有文本才能被 Embedding 模型处理 |
|
全文检索 |
ElasticSearch 等搜索引擎索引的是文本 |
|
切片 |
按句子/段落切分,需要先有文本 |
|
展示 |
给用户看原文片段 |
3. 元数据抽取
3.1 什么是元数据
元数据(Metadata)是“关于数据的数据”,描述文档本身的属性。
常见的元数据:
|
字段 |
说明 |
示例 |
|---|---|---|
|
|
MIME 类型 |
|
|
|
文档标题 |
2024年度报告 |
|
|
作者/创建者 |
张三 |
|
|
创建时间 |
2024-01-15T10:30:00 |
|
|
修改时间 |
2024-03-20T14:00:00 |
|
|
页数 |
15 |
|
|
字数 |
5000 |
3.2 元数据在 RAG 中的价值
场景 1:溯源
用户问:这个信息来自哪份文档?
如果你保存了元数据,可以回答:来自《2024年度报告》,作者是张三,创建于2024年1月15日。
场景 2:过滤
用户说:只搜索最近一年的文档。
如果你有 created 字段,可以做时间过滤。
场景 3:权限控制
某些文档有 department: 财务部 的元数据,只有财务部员工能查。
3.3 Tika 提取元数据示例
Metadata metadata = new Metadata(); // ... 解析文件 ... // 获取元数据
String author = metadata.get("creator");
String title = metadata.get("title");
String createDate = metadata.get("dcterms:created");
4. OCR
4.1 什么是 OCR
OCR(Optical Character Recognition,光学字符识别)是一种技术,能把图片中的文字识别成可编辑的文本。
4.2 什么时候需要 OCR
|
场景 |
需要 OCR 吗 |
|---|---|
|
Word 导出的 PDF |
不需要,文字可直接提取 |
|
扫描仪扫描的 PDF |
需要,内部是图片 |
|
手机拍的照片 |
需要,是图片 |
|
PNG/JPG 图片 |
需要,是图片 |
|
截图 |
需要,是图片 |
4.3 Tika 与 OCR 的关系
Tika 本身不包含 OCR 引擎,但可以对接外部 OCR 工具:
-
Tesseract(开源,最常用)
-
Adobe Acrobat(商业)
-
ABBYY(商业,效果最好)
-
建议:先尝试直接文本提取,只有提取为空/内容过少时再走 OCR。
5. 解析失败的常见原因与处理策略
|
问题 |
表现 |
原因 |
|---|---|---|
|
空文本 |
解析结果是空字符串 |
扫描 PDF 没配 OCR;加密文档 |
|
乱码 |
出现 |
编码不匹配 |
|
内容缺失 |
只有部分内容 |
解析器不支持某些特性 |
|
格式混乱 |
大量无意义换行/空格 |
表格、多栏排版 |
|
解析报错 |
抛出异常 |
文件损坏;格式不支持 |
|
超时 |
解析很久不返回 |
文件太大;复杂嵌套 |
代码实现流程:
1.拿到file文件 --> 判断文件是否为空 --> 用try检测file --> 再次用字符流获取流-->tika.detect方法获取tmime类型-->Metadata设置文件名-->AutoDetectParser()的parse方法进行解析,放入file的steam流+BodyContentHandler(MAX_TEXT_LENGTH)(接收结果)+Metadata();(接收元数据)+ParseContext()(解析上下文)--> 获取的结果tostring--> 清洗文本 --> 提取元数据
数据分块
几个关键参数:chunkSize、overlap
hunkSize 就是每个块的长度上限。一般来说,200 到 1000 个字符是比较常见的范围,具体取决于你的文档类型和检索需求。
overlap(重叠)是指相邻两个块之间共享的文本长度。一般经验是 overlap 设为 chunkSize 的 10%~25%。
分块策略
1. 固定大小分块(Fixed Size Chunking)
这是最简单粗暴的方式:不管文本内容是什么,每隔固定数量的字符就切一刀。
1.3 优缺点
|
维度 |
说明 |
|---|---|
|
优点 |
实现极其简单,性能好,不需要任何 NLP 处理 |
|
缺点 |
完全忽略文本结构,容易把句子、段落从中间切断,导致语义不完整 |
|
适合 |
文本结构不重要的场景,比如日志文件、纯数据文本;或者作为其他策略的兜底方案 |
|
不适合 |
有明确段落结构的文档(知识库、产品手册、政策文件),因为切断语义会严重影响检索质量 |
2. 重叠分块(Overlapping Chunking)
重叠分块是对固定大小分块的直接改进。核心思路很简单:切块的时候,相邻两个块之间留一段重叠区域,这样即使切割点落在句子中间,重叠部分也能保证关键信息不会被完全切断。
2.3 优缺点
|
维度 |
说明 |
|---|---|
|
优点 |
实现简单,有效缓解边界处的语义断裂问题 |
|
缺点 |
仍然不看文本内容,只是用重叠来弥补;overlap 会导致存储量增加 |
|
适合 |
大多数通用场景的入门方案,尤其是你还没确定用什么策略的时候 |
|
不适合 |
对语义完整性要求很高的场景,比如法律条款、合同文本 |
3. 递归分块(Recursive Chunking)
3.1 原理
递归分块是目前实践中最常用的策略。它的思路可以用一句话概括:先尝试用最大的分隔符切,切完如果某个块还是太大,就换一个更小的分隔符继续切,直到所有块都在 chunkSize 以内。
具体来说,它维护一个分隔符列表,按优先级从高到低排列,比如:
["\n\n", "\n", "。", ",", " ", ""]
3.2 优缺点
|
维度 |
说明 |
|---|---|
|
优点 |
兼顾了语义完整性和块大小控制,是目前最通用的分块策略 |
|
缺点 |
分隔符列表需要根据语言调整(中文和英文的标点不同);依赖文本中存在合理的分隔符 |
|
适合 |
绝大多数场景,尤其是你不确定该用什么策略的时候,递归分块是最安全的默认选择 |
|
不适合 |
对分块有特殊要求的场景,比如代码文件(需要按函数/类来切)、表格数据(需要按行来切) |
4. 语义分块(Semantic Chunking)
4.1 原理
用 Embedding 模型来判断文本的语义相似度,在语义发生明显变化的地方切割。
- 1.先把文本按句子拆开(这一步可以简单地按句号切)
- 2.对每个句子生成一个向量(Embedding)
- 3.计算相邻句子之间的向量相似度
- 4.当相邻句子的相似度低于某个阈值时,说明话题发生了转换,在这里切一刀
对比 Embedding vs LLM 分块:
|
维度 |
Embedding 语义分块 |
LLM 辅助分块 |
|---|---|---|
|
原理 |
计算相邻句子的向量相似度 |
大模型直接理解文本语义 |
|
分块质量 |
依赖 Embedding 模型质量 |
通常更准确,能处理复杂语境 |
|
速度 |
快(毫秒级) |
慢(秒级) |
|
成本 |
低 |
高 |
|
适用场景 |
大批量文档处理 |
高价值文档、需要精细分块 |
4.2 优缺点
|
维度 |
说明 |
|---|---|
|
优点 |
切割点基于语义而非规则,分块质量最高,每个块的主题高度内聚 |
|
缺点 |
需要调用 Embedding 或者 Chat 模型,有额外的计算成本和延迟;阈值需要调参;对模型的质量有依赖 |
|
适合 |
对检索精度要求很高的场景,比如法律文档问答、医疗知识库、金融合规文档 |
|
不适合 |
文档量特别大且对延迟敏感的场景;文本本身结构已经很清晰的场景(用递归分块就够了,没必要上语义分块) |
5. 混合分块(Hybrid Chunking)
5.1 原理
第一种,递归分块 + 语义分块。先用递归分块做粗切,把文本按段落、章节切成大块;然后对每个大块再用语义分块做细切,确保每个最终的块在语义上是内聚的。
第二种,按文档类型选策略。比如在一个企业知识库系统中,产品手册用递归分块,FAQ 用按问答对切割,合同文本用语义分块。在代码层面,就是一个路由逻辑,根据文档的类型或来源选择不同的分块器。
第三种,分块 + 后处理。先用递归分块切完,然后对结果做一轮后处理:合并太短的块、拆分太长的块、给每个块补充元数据(比如所属章节标题、文档来源)。
5.2 优缺点
|
维度 |
说明 |
|---|---|
|
优点 |
灵活,能针对不同内容选择最合适的策略,整体效果最好 |
|
缺点 |
实现复杂度高,需要维护多套分块逻辑和路由规则 |
|
适合 |
企业级 RAG 系统,文档类型多样,对检索质量有较高要求 |
|
不适合 |
简单的 demo 或 POC 阶段,杀鸡用牛刀 |
1. 不同文档类型的推荐策略
|
文档类型 |
推荐策略 |
理由 |
|---|---|---|
|
产品手册 / 知识库 |
递归分块 |
有清晰的章节、段落结构,递归策略能很好地利用这些结构 |
|
FAQ / 问答对 |
递归分块 |
每个 Q&A 是一个自然单元,不应该被拆开 |
|
合同 / 法律文档 |
语义分块 |
条款之间的边界需要精确识别,规则分块容易切错 |
|
日志文件 |
固定大小分块或按行切割 |
日志通常每行一条记录,结构简单 |
|
代码文件 |
专用的代码分块器(按函数/类切) |
通用的文本分块策略不适合代码,需要理解代码结构 |
|
HTML 页面 |
先清洗 HTML 标签,再用递归分块 |
HTML 标签会干扰分块,需要先处理 |
|
格式混乱的文本(OCR 等) |
重叠分块 |
没有可靠的分隔符可用,重叠至少能缓解边界断裂 |
|
多类型混合的企业知识库 |
混合分块 |
不同类型的文档用不同策略,效果最好 |
3. 企业级解决方案
实项目里,分块效果不好,往往不只是 chunkSize 没调对,还有可能是上游抽取出来的文本就已经“脏”了 ——尤其是 PDF 这种格式:
-
页眉页脚、目录、页码混进正文,语义被大量噪音稀释
-
断行/连字把一句话拆成多段,导致按段落/句子递归分割失效
-
表格被打散成碎词或错位字段,检索命中但无法形成可读上下文
-
更稳妥的流程是:先用Tika等工具做文本抽取→再用清洗器做结构修复与去噪→最后才进入分块与向量化 。
-
针对中小规模文档 ,更实用的做法是:先用基础策略把文档拆成初稿块,然后在此基础上做一轮人工二次编排

这里是“一人公司”的成长家园。我们提供从产品曝光、技术变现到法律财税的全栈内容,并连接云服务、办公空间等稀缺资源,助你专注创造,无忧运营。
更多推荐


 9
 0
- 0


 已为社区贡献3条内容

所有评论(0)