Ragent项目 day-01
大模型的7B指的是7billion,70亿个参数,参数你可以把它理解为模型大脑里的连接数。人类大脑有大约 100 万亿个突触连接,这些连接存储了我们的记忆、知识和思维能力。大模型的参数类似——每个参数都是一个数字,所有参数组合在一起,构成了模型对语言的理解能力。
Token:大模型的计量单位
-
英文:大致 1 个单词 ≈ 1~1.5 个 Token。比如 "hello" 是 1 个 Token,"unbelievable" 可能被切成 "un" + "believ" + "able" 共 3 个 Token
-
中文:大致 1 个汉字 ≈ 1~2 个 Token。比如“你好”可能是 2 个 Token,“人工智能”可能是 2~3 个 Token
上下文窗口:
上下文窗口是模型一次对话中能看到的文本总量上限,单位是 Token。包含了你发给模型的所有内容(系统提示词 + 历史对话 + 当前问题)和模型的回答
Temperature:控制回答的创造力
Temperature(温度)是调用大模型时的一个重要参数,用来控制回答的随机性。
-
Temperature = 0:模型每次都会选择概率最高的那个词,回答最确定、最稳定,但可能比较死板
-
Temperature = 0.7:模型会在高概率的词里随机选择,回答更自然、更有变化
-
Temperature = 1.0 或更高:模型的选择更加随机,回答更有创意,但也更容易胡说八道
| 场景 | 推荐 Temperature | 原因 |
|---|---|---|
| RAG 问答 | 0~0.3 | 需要准确回答,不要发挥 |
| 代码生成 | 0~0.2 | 代码需要精确,不能有随机性 |
| 日常对话 | 0.5~0.7 | 需要自然流畅,但不能太离谱 |
| 创意写作 | 0.7~1.0 | 需要多样性和创造力 |
MoE:混合专家架构
moe框架就是本来有100b的参数,推理时计算开销只用37b的参数。
主流大模型:
1. 国际主流模型
| 模型系列(举例) | 厂商 | 特点 | 是否开源 |
|---|---|---|---|
| GPT 系列(GPT-5.2 / GPT-5.2 pro 等) | OpenAI | 综合能力与生态最成熟;推理、工具调用、Agent 工作流能力强 | 否 |
| Claude 系列(Claude Opus 4.6 / Sonnet 4.6) | Anthropic | 代码与长上下文能力突出;“computer use/代理”能力强;安全与对齐投入大 | 否 |
| Gemini 系列(Gemini 3.1 Pro / Gemini 3 Flash) | | 原生多模态(文/图/音/视频);超长上下文(最高 1M);与 Google 生态结合紧密 | 否 |
| Llama 系列(Llama 4 Scout / Maverick) | Meta | 开放权重生态最强之一;社区活跃、部署与微调方案成熟;MoE + 多模态 | 是(开放权重) |
2. 国内主流模型
国内大模型这两年发展很快,尤其是开源模型,在中文场景下的表现已经非常出色。
| 模型系列(最新) | 厂商 | 特点 | 是否开源 |
|---|---|---|---|
| DeepSeek 系列(V3 / R1 等) | 深度求索(DeepSeek) | 性价比高;推理能力强(R1);开放权重、可商用;社区生态活跃 | 是(MIT)(Hugging Face) |
| 通义千问 Qwen 系列(Qwen3.5) | 阿里云 / 阿里巴巴 | Agent 生态强、工具调用/多模态路线清晰;尺寸覆盖广;开源生态完善 | 是(Apache-2.0,开放权重)(Hugging Face) |
| 智谱 GLM 系列(GLM-5) | 智谱 AI / Z.ai | 面向复杂系统工程与长程 Agent 任务;推理/编码/Agentic 能力强化;GLM-5 已开源且 MIT 许可 | 是(MIT) (Hugging Face) |
| MiniMax 系列(MiniMax-M1 / abab 6.5) | MiniMax | M1 主打超长上下文 + 高效推理(百万级输入);abab 6.5 系列面向通用对话/长上下文 | 部分开源(M1 开源 Apache-2.0;abab 多为服务型) (MiniMax) |
| Kimi 系列(Kimi K2.5) | 月之暗面(Moonshot AI) | 长文档/多模态 + Agent;K2.5 开源权重,Modified MIT 许可;并提供兼容 OpenAI/Anthropic 的 API | 是(Modified MIT) (Hugging Face) |
Chat 模型:我们真正要调用的东西
你在网页端用的 DeepSeek、通义千问,或者通过 API 调用的模型,其实都是一种特定类型的大模型——Chat 模型。但大模型并不是天生就会聊天的,它需要经过专门的训练才能变成一个合格的对话助手。
基座模型(Base Model):预训练阅读海量文本获得的模型,只会续写,不会回答。
Chat 模型:对齐训练,在基座模型基础上通过指令微调和人类反馈强化学习等技术,教模型理解人类的指令,并按照指令给出有用、安全的回答。训练完成后得到的就是 Chat 模型(也叫 Instruct 模型)。
常见后缀含义:
| 后缀 | 含义 | 示例 |
|---|---|---|
| -Instruct | 经过指令微调的 Chat 模型 | Qwen2.5-7B-Instruct |
| -Chat | 和 Instruct 类似,强调对话能力 | GLM-4-Chat |
| -GPTQ / -AWQ | 量化版本,模型体积更小,适合低资源部署 | Qwen2.5-7B-Instruct-GPTQ-Int4 |
基座模型(Base Model)通常会明确标注 -Base 后缀,主要是给做模型微调的研究人员用的。
本地部署模型时的量化
大模型的参数本质上就是一堆数字(权重)。当你输入一句话时,模型会把这句话拆成一个个词(token),然后通过成千上万层的计算,最终算出下一个词最可能是什么。而每一层计算里用到的那些乘法系数、加法偏移量,就是所谓的参数——它们都是具体的数字,比如 0.0012、-1.357、0.889 这样的小数。模型在训练阶段通过海量文本不断调整这些数字,让它的打分越来越准。训练完成后,这些数字就固定下来,保存成文件——这就是你下载到的模型文件。
浮点数精度:FP32、FP16、BF16 都是什么
计算机用浮点数来表示带小数点的数字。一个浮点数由三部分组成:
-
符号位(Sign):1 位,表示正数还是负数
-
指数位(Exponent):决定数字的范围(能表示多大或多小的数)
-
尾数位(Mantissa / Fraction):决定数字的精度(小数点后能精确到第几位)
-
格式
纸条大小(总位数)
省市部分(指数位)
门牌号部分(尾数位)
能寄多远(数值范围)
地址能写多细(精度)
FP32
32 格(4 字节)
8 格
23 格
全球都能寄(±3.4×10³⁸)
精确到xx栋xx单元xx室
TF32
19 格(NVIDIA 专用)
8 格
10 格
全球都能寄(同 FP32)
精确到xx栋xx单元
BF16
16 格(2 字节)
8 格
7 格
全球都能寄(同 FP32)
只能到xx栋
FP16
16 格(2 字节)
5 格
10 格
只能寄本省(±65504)
精确到xx栋xx单元
-
格式
位数
每参数占用
核心特点
FP32
32 位
4 字节
传统的“全精度”,范围大、精度高,但太占显存,现在很少直接用来存模型权重
TF32
19 位
—
NVIDIA Ampere 架构(A100 等)引入的格式,保留 FP32 的范围但砍掉一半精度,GPU 内部自动使用,开发者一般不用管
FP16
16 位
2 字节
“半精度”,体积是 FP32 的一半,但能表示的数值范围很小(最大约 6.5 万),训练时容易溢出
BF16
16 位
2 字节
Google 提出的“脑浮点”,和 FP16 一样大,但把更多位数分给了指数(范围和 FP32 一样大),牺牲了一点精度换来了训练稳定性
打个比方:FP16 就像一个只做同城配送的快递员,他能把包裹精确送到你家门口,但出了本市就没辙;BF16 则像一个全国快递员,哪个省都能送到,但可能只送到小区门口,最后几百米得你自己走。
对于大模型训练来说,参数的数值变化范围非常大,如果“寄不到”(溢出)就直接算错了,而“地址粗一点”(精度低一点)影响没那么致命。所以 BF16 成了目前大模型训练和推理的主流选择。
-
在 Hugging Face 上看到的大多数模型,默认权重格式就是 BF16。当我们说“原始精度”或“未量化”时,通常指的就是 BF16(而不是 FP32)。
-
量化:用更低的精度换更小的体积
理解了上面的精度格式之后,量化就很好理解了——它就是把模型权重从 BF16/FP16(16 位)进一步压缩到更低的位数,比如 INT8(8 位整数)或 INT4(4 位整数)。精度降低了,每个参数占用的空间也就小了:
-
格式
全称
特点
GPTQ
GPT Post-Training Quantization
需要 GPU 推理;量化后精度较好;社区支持广泛
AWQ
Activation-aware Weight Quantization
需要 GPU 推理;比 GPTQ 更快,精度相当;较新的方案
GGUF
GPT-Generated Unified Format
支持 CPU 推理(也支持 GPU);llama.cpp 生态的标准格式;适合没有独显或显存不够的场景
-
深度思考:大模型的深度思考模式
- 思维链的核心思想很简单:让模型把推理过程一步步说出来,而不是直接跳到结论。模型在回答之前,会先生成一段 thinking 内容(推理过程),这段内容对用户可见(在网页端会折叠显示),然后再输出最终答案。
-
网页端 vs API 调用:为什么开发者需要 API
-
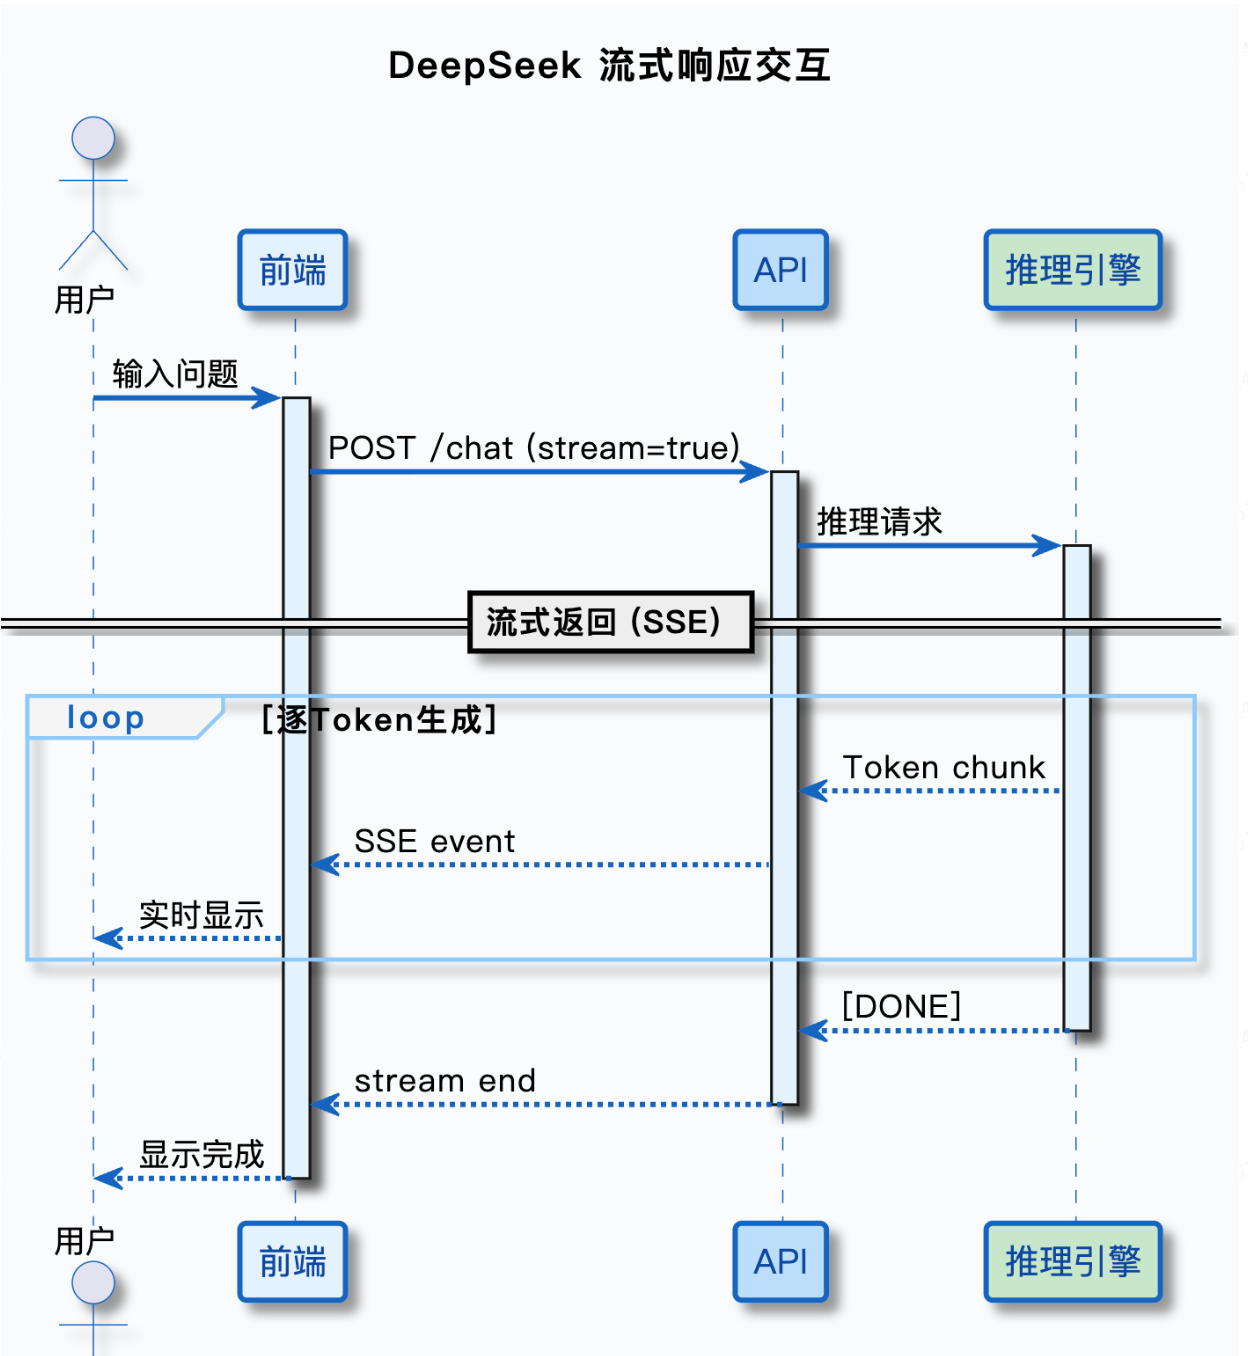
你在网页端用 DeepSeek 时,背后发生了什么
-
这一篇咱们从零开始,把大模型的核心认知梳理了一遍:
-
大模型通过阅读海量文本学会了语言的规律,能真正理解自然语言,这是它和传统编程、传统 NLP 的本质区别
-
参数量决定了模型的大脑容量,但不是越大越好,要根据场景选择合适的尺寸
-
Token、上下文窗口、Temperature 是调用 API 时绑定出现的核心概念
-
我们调用的都是 Chat 模型(经过对齐训练的模型),不是基座模型
-
深度思考(CoT)适合推理场景,RAG 场景下通常不需要
-
开发者需要通过 API 调用大模型,才能把它集成到自己的系统中
-
本系列的技术选型:
- API 平台:SiliconFlow(硅基流动)
- 模型选择:Qwen 系列

这里是“一人公司”的成长家园。我们提供从产品曝光、技术变现到法律财税的全栈内容,并连接云服务、办公空间等稀缺资源,助你专注创造,无忧运营。
更多推荐


 11
 0
- 0


 已为社区贡献3条内容

所有评论(0)